 Chat en direct
 Se connecter


Guide sur l'infrastructure de surveillance des prix en e-commerce
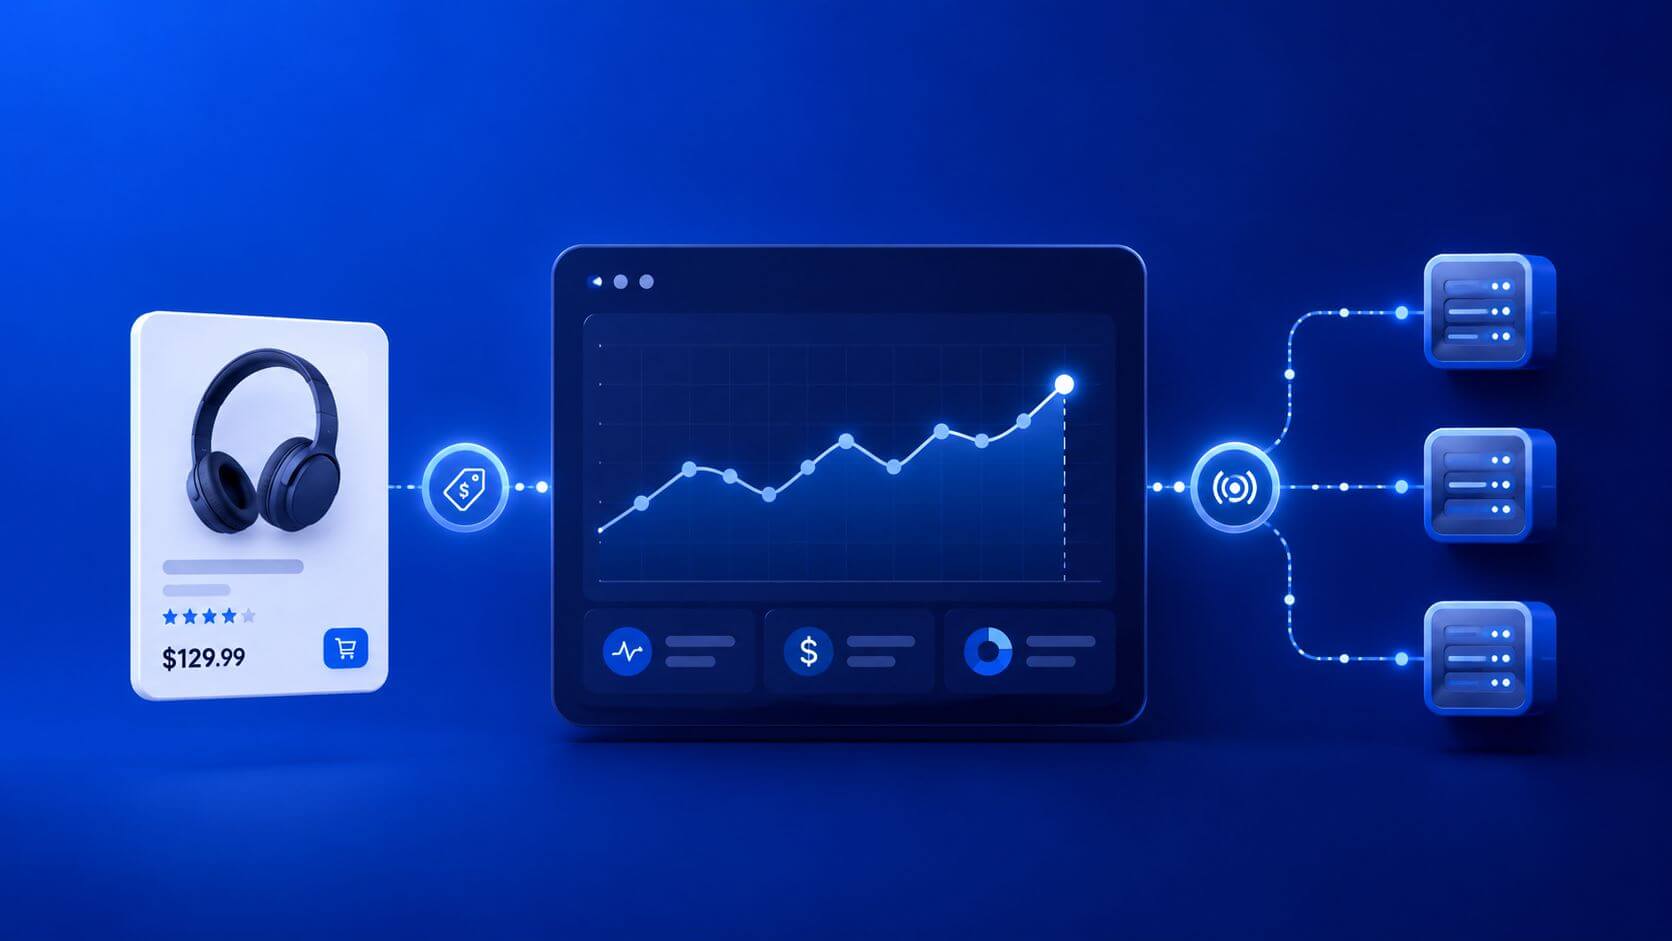
Les prix du commerce électronique changent rapidement. Les concurrents ajustent les prix, les places de marché affichent différentes offres selon la région, les promotions expirent sans avertissement et la disponibilité des produits peut changer plusieurs fois par jour. Si votre système de surveillance est lent, bruyant ou incomplet, vos décisions de tarification deviennent réactives au lieu d'être stratégiques.
La surveillance des prix du commerce électronique est le processus de collecte des prix des produits, de la disponibilité, des promotions, des signaux d'expédition et des variations régionales à partir de sites cibles selon un calendrier défini. Une infrastructure solide utilise des récupérateurs fiables, un rendu de navigateur sélectif, des proxies de scraping web, des parseurs résilients, des règles de validation et des tableaux de bord de surveillance pour maintenir les données de prix précises, opportunes et contrôlées en termes de coûts.
L'objectif n'est pas seulement de scraper plus de pages. L'objectif est de collecter des informations sur les prix exploitables à grande échelle avec un coût prévisible, de faibles taux de blocage et une forte qualité des données.
Qu'est-ce que l'infrastructure de surveillance des prix du commerce électronique ?
L'infrastructure de surveillance des prix du commerce électronique est le système complet derrière la collecte automatisée des prix. Elle découvre des URL, planifie des tâches, récupère des pages, rend du contenu dynamique lorsque nécessaire, extrait des champs de prix structurés, valide les données, normalise les résultats, stocke des enregistrements historiques et alerte les équipes lorsque les prix changent.
Une infrastructure complète comprend généralement :
- découverte d'URL de produits
- planification de crawl
- récupération HTTP
- rendu de navigateur lorsque nécessaire
- routage de proxy
- gestion de session
- extraction de prix
- normalisation des devises
- analyse de disponibilité
- gestion des doublons
- assurance qualité
- stockage des données
- surveillance et alertes
Un simple scraper peut fonctionner pour quelques produits. Mais une fois que vous surveillez des milliers de SKU à travers plusieurs détaillants, régions ou places de marché, vous avez besoin d'un système de qualité production.
Pourquoi la surveillance des prix devient difficile à grande échelle
La surveillance des prix devient difficile car les pages produits ne sont pas statiques.
Les défis courants incluent :
- prix changeant selon la région ou le code postal
- promotions apparaissant uniquement pour certains utilisateurs
- variantes de produits avec des prix différents
- différences de devises entre les marchés
- prix dynamiques chargés via JavaScript
- cookies ou portes de consentement cachant le contenu
- blocs doux retournant des pages produits vides
- tests A/B modifiant la structure de la page
- volume de requêtes élevé déclenchant des limites de taux
- échecs de parseur après des refontes de site
Si ces problèmes ne sont pas gérés correctement, les tableaux de bord peuvent afficher des prix obsolètes, manquants ou incorrects. Cela peut affecter les marges, les décisions d'enchères, la planification des stocks et l'analyse des concurrents.
Architecture de base pour la surveillance des prix
Une solide pile de surveillance des prix du commerce électronique doit être modulaire. Chaque couche doit bien faire un travail.
Product URL List
   ↓
Scheduler
   ↓
Fetcher / Browser Renderer
   ↓
Proxy Router
   ↓
Parser
   ↓
Validation Layer
   ↓
Normalizer
   ↓
Storage
   ↓
Alerts + Dashboards
Planificateur
Le planificateur décide quand chaque produit, catégorie ou détaillant doit être vérifié. Les produits de grande valeur peuvent nécessiter des vérifications horaires, tandis que les catégories à faible volatilité peuvent n'avoir besoin que d'une surveillance quotidienne ou hebdomadaire.
Récupérateur
Le récupérateur collecte le contenu des pages en utilisant des requêtes HTTP. Il doit gérer les en-têtes, les délais d'attente, les nouvelles tentatives, les redirections et l'attribution de proxy.
Rendu
Le rendu utilise un navigateur lorsque le contenu est chargé par JavaScript ou caché derrière une logique côté client. Le rendu par navigateur est plus coûteux que la récupération HTTP, il doit donc être utilisé de manière sélective.
Routeur de proxy
Le routeur de proxy décide si chaque requête doit utiliser un accès direct, des proxies de datacenter, des proxies résidentiels, ou des itinéraires spécifiques à la région.
Parseur
Le parseur extrait des champs structurés tels que le prix, la devise, le prix de vente, le prix de liste, la disponibilité, le SKU, le titre du produit, la marque, la note et les informations d'expédition.
Couche de validation
La couche de validation vérifie si les données extraites sont plausibles. Elle doit détecter les prix manquants, les mauvaises devises, les blocages temporaires, les pages vides et les changements de prix anormaux.
Stockage
La couche de stockage conserve les captures brutes, les enregistrements normalisés, les horodatages, les URL sources, les versions de parseur et les métadonnées de route.
Choisir la bonne méthode de collecte de données
Utilisez la méthode la plus légère qui renvoie des données complètes et fiables.
| Méthode de collecte | Meilleur pour | Principal compromis |
|---|---|---|
| ------------------------------ | ------------------------------ | ----------------------------------------- |
| Analyse HTML statique | Pages produits simples | Rapide, mais fragile aux changements de mise en page |
| Points de terminaison JSON/XHR | Sites exposant des données structurées | Efficace, mais les points de terminaison peuvent changer |
| Rendu de navigateur sans tête | Pages produits riches en JavaScript | Précis, mais plus lent et plus coûteux |
| APIs officielles ou flux partenaires | Accès aux données approuvées | Fiable, mais limité par les conditions et les quotas |
Commencez par des points de terminaison HTML ou JSON. Passez au rendu de navigateur uniquement si nécessaire.
Le rendu de navigateur doit être utilisé lorsque :
- le prix n'est pas présent dans le HTML brut
- le contenu se charge après l'exécution de JavaScript
- les variantes nécessitent une interaction
- les pages dépendent des cookies ou de l'état de consentement
- des captures d'écran sont nécessaires pour l'assurance qualité
Évitez d'utiliser des navigateurs complets pour chaque page si HTML ou JSON renvoie les mêmes données de manière fiable. Cela permet de contrôler les coûts d'infrastructure.
Stratégie de proxy pour la surveillance des prix en e-commerce
Le routage des proxies est l'une des parties les plus importantes de la surveillance des prix. Les sites de vente au détail et de marché varient souvent le contenu en fonction de la localisation, détectent les modèles d'accès répétés et appliquent des limites de taux.
Utilisez des proxies de datacenter lorsque :
- vous surveillez des pages de liste à fort volume
- vous collectez des pages publiques à faible friction
- les données de prix ne sont pas fortement sensibles à la géolocalisation
- la vitesse et le coût sont des priorités
- les cibles tolèrent le trafic côté serveur
Utilisez des proxies résidentiels lorsque :
- les prix varient selon le pays, la ville ou le code postal
- les pages produits sont sensibles au trafic automatisé
- les signaux de navigation semblables à ceux des consommateurs comptent
- les sessions nécessitent plus de stabilité
- les pages de marché bloquent les routes de datacenter
Un modèle de routage pratique :
| Charge de travail | Route recommandée | Pourquoi |
|---|---|---|
| ----------------------- | -------------------------------------- | --------------------------------------- |
| Pages de catégorie | Proxies de datacenter | Rapide et rentable |
| Pages de détails produits | Datacenter d'abord, secours résidentiel | Contrôle des coûts tout en améliorant la couverture |
| Tarification spécifique à la région | Proxies résidentiels | Meilleure réalité géographique |
| Surveillance des ventes flash | Résidentiel + rendu sélectif | Meilleur succès pour les pages sensibles au temps |
| Commerçants à forte friction | Proxies résidentiels | Meilleure survie de session |
| Flux de produits statiques | Accès direct/API | Coût inférieur et moins de pièces mobiles |
La meilleure configuration est généralement hybride. Utilisez des routes moins chères pour les pages faciles et réservez les proxies résidentiels pour les pages où ils améliorent le taux de succès, la précision géographique ou la qualité des données.
Stratégie de session et règles de rotation
Toutes les demandes de surveillance des prix ne doivent pas être rotatives de la même manière.
Pour les pages produits indépendantes, la rotation peut aider à répartir la charge. Pour les flux spécifiques à une région ou à plusieurs étapes, les sessions collantes peuvent être plus fiables.
Utilisez une rotation courte lorsque :
- les pages sont indépendantes
- aucun cookie n'est requis
- le volume est élevé
- le contenu n'est pas sensible à la session
Utilisez des sessions collantes lorsque :
- vous vérifiez des variantes
- vous naviguez à travers la pagination des catégories
- vous validez des paniers ou des estimations d'expédition
- vous collectez des prix régionaux
- vous gérez le consentement des cookies
- vous comparez plusieurs pages du même détaillant
Un point de départ pratique :
| Flux de travail | Politique de session |
|---|---|
| Pages de liste | Rotation par lot |
| Pages de détails produit | Sticky 5–15 minutes pour les cibles sensibles |
| Vérifications de variantes | Même session pour toutes les variantes |
| Vérifications de prix régionaux | Sticky par région |
| Surveillance des ventes flash | Sessions sticky courtes avec des limites strictes de réessai |
Évitez de faire tourner les IP au milieu d'un flux de travail multi-étapes. Cela peut rompre la cohérence de la session et produire des prix incorrects.
Gestion des prix régionaux et des différences de devises
De nombreux détaillants et places de marché renvoient des prix différents en fonction de l'emplacement. Un produit peut avoir un prix aux États-Unis, un autre au Canada, et un statut de disponibilité différent en Allemagne.
Pour collecter des prix spécifiques à une région de manière fiable, alignez :
- pays ou ville du proxy
- sélecteur de région du site web
- paramètres de langue
- devise
- destination d'expédition
- fuseau horaire du navigateur
- cookies et état de session
Votre système doit stocker la région et la devise au moment de la capture. Ne supposez pas que tous les prix d'un même domaine utilisent la même devise ou le même marché.
Champs importants à stocker :
- prix
- prix de liste
- prix de vente
- devise
- région
- lieu d'expédition
- disponibilité
- horodatage
- URL source
- route du proxy
- version du parser
Cela rend l'analyse en aval beaucoup plus fiable.
Validation des données : Ne faites pas confiance à l'extraction brute
Les systèmes de surveillance des prix doivent valider les valeurs extraites avant de les envoyer aux tableaux de bord.
Les vérifications de validation courantes incluent :
- le prix est numérique
- la devise est présente
- le prix est dans la plage attendue
- le prix de vente est inférieur au prix de liste
- le statut de disponibilité est reconnu
- le titre du produit correspond au SKU attendu
- la page n'est pas une page CAPTCHA ou de blocage
- la longueur du contenu est normale
- la variante du produit est correcte
- la région correspond à la cible prévue
Une page peut renvoyer HTTP 200 et être pourtant inutile. Validez toujours la structure du contenu.
Détection des blocages doux
Un blocage doux se produit lorsque la page se charge avec succès mais ne contient pas de données produit valides.
Exemples incluent :
- zone produit vide
- nœud de prix manquant
- page CAPTCHA avec HTTP 200
- modèle d'erreur générique
- page de consentement remplaçant le contenu produit
- HTML identique répété sur de nombreux produits
- corps de réponse anormalement court
- page produit sans SKU ni titre
Les blocages doux sont dangereux car ils peuvent ressembler à des demandes réussies. Votre couche de validation doit les détecter avant qu'ils n'entrent dans les rapports.
Ce qu'il faut mesurer
La surveillance des prix de l'e-commerce doit être mesurée comme un pipeline de données de production.
| Métrique | Pourquoi c'est important |
|---|---|
| Taux de succès | Montre à quelle fréquence des prix valides sont collectés |
| Taux de blocage | Suit les pages 403, 429, CAPTCHA et de défi |
| Taux de blocage doux | Détecte les pages invalides renvoyées comme succès |
| CPSR | Mesure le coût par prix réussi |
| Profondeur de réessai | Révèle une instabilité cachée |
| Taux d'erreur du parser | Suit les échecs d'extraction |
| Taux de prix manquant | Montre une couverture produit incomplète |
| Précision géo | Confirme la validité des prix spécifiques à la région |
| Latence P95 | Protège les objectifs de fraîcheur |
| Taux d'anomalie de prix | Signale des changements de prix suspects |
CPSR signifie coût par demande réussie.
En termes simples : le CPSR vous indique combien coûte chaque enregistrement de prix valide après les dépenses de proxy, le calcul, le rendu du navigateur, les réessais et les tentatives échouées.
Une route de proxy plus coûteuse peut toujours être meilleure si elle réduit les réessais et améliore la couverture des prix valides.
Stratégie de contrôle des coûts
La surveillance des prix peut devenir coûteuse si chaque demande utilise des proxies premium et un rendu complet du navigateur.
Contrôlez les coûts en hiérarchisant la charge de travail :
- Utilisez des API ou des flux officiels lorsque cela est possible.
- Utilisez le parsing HTML statique lorsque suffisamment de données sont présentes.
- Utilisez des points de terminaison JSON lorsque cela est fiable et autorisé.
- Utilisez des proxies de datacenter pour les pages tolérantes.
- Utilisez des proxies résidentiels pour les pages sensibles ou régionales.
- Utilisez le rendu par navigateur uniquement lorsque cela est nécessaire.
- Limitez la profondeur de réessai.
- Réduisez la cadence pour les produits à faible volatilité.
- Priorisez les SKU à forte valeur.
- Suivez le CPSR par détaillant et par route.
Pour la planification, comparez le volume de SKU, la fréquence de crawl et les exigences de route par rapport aux plans et tarifs de proxy de SquidProxies.
Scénario du monde réel : Surveillance des prix sur les marchés à travers les régions
Une équipe de tarification suit 50 000 SKU à travers les États-Unis, le Royaume-Uni et l'Allemagne.
La première version utilise la même route de datacenter pour chaque demande. Elle collecte de nombreuses pages rapidement, mais les prix régionaux sont incohérents et certaines pages de produits renvoient des champs de prix manquants.
Le système amélioré utilise :
- des proxies de datacenter pour les pages de catégorie et de liste
- des proxies résidentiels pour les pages de détails de produit
- un routage spécifique à la région pour des prix localisés
- des vérifications de validation pour la devise et la disponibilité
- des alertes de parser lorsque le taux de prix manquant augmente
Le résultat est une meilleure précision régionale sans utiliser de routes coûteuses pour chaque page.
Scénario du monde réel : Détection de vente flash
Un détaillant organise des promotions courtes qui peuvent durer moins d'une heure.
Le système de surveillance doit détecter rapidement les baisses de prix sans surcharger l'infrastructure.
L'équipe utilise :
- des vérifications fréquentes uniquement pour les SKU à forte valeur
- le rendu par navigateur sans tête pour les pages avec des bannières de vente dynamiques
- des proxies résidentiels pour les domaines de détaillants les plus sensibles
- des limites strictes de réessai
- des alertes basées sur les deltas de prix et les vérifications de confiance
Cela permet de garder la détection des promotions rapide tout en limitant les coûts.
Modes de défaillance courants
Tarification des variantes cachées
Un produit change de prix selon la taille, la couleur, le modèle ou le vendeur. Le parser ne récupère que l'option par défaut.
Corrigez cela en rendant les parsers conscients des variantes et en stockant les identifiants de variante.
Dérive de devise
Le système collecte des prix de différentes régions mais les normalise incorrectement.
Corrigez cela en capturant la devise au moment du parsing et en stockant la conversion de change séparément.
Dérive du parser
Une refonte du site modifie le balisage des produits.
Corrigez cela en surveillant le taux de prix manquant, le taux de champ nul et la performance de la version du parser.
Utilisation excessive de navigateurs sans tête
Les navigateurs augmentent les coûts et la latence.
Corrigez cela en utilisant le rendu par navigateur uniquement lorsque cela améliore la sortie valide.
Réessais excessifs
Les tempêtes de réessai augmentent le CPSR et peuvent aggraver les blocages.
Corrigez cela en classifiant les échecs, en limitant les réessais et en utilisant un backoff.
Considérer un prix manquant comme une rupture de stock
Un prix manquant peut signifier un échec du parser, une page bloquée ou un problème de variante — pas une indisponibilité réelle.
Corrigez cela en validant la structure de la page avant d'attribuer un sens commercial.
Liste de contrôle avant le lancement
Avant de lancer un pipeline de surveillance des prix en production, confirmez :
- le contrat de données est défini
- le mapping des SKU est stable
- les régions cibles sont documentées
- le routage des proxies est assigné par charge de travail
- des tests de parser existent pour chaque détaillant
- des captures d'écran ou du HTML sont prises en cas d'échec
- les règles d'anomalie de prix sont actives
- les alertes de prix manquant sont configurées
- la profondeur de réessai est limitée
- le CPSR est suivi par route
- la validation de la devise régionale est activée
- les règles de conformité sont documentées
Pour des modèles de mise en œuvre plus larges, les tutoriels de proxy de SquidProxies peuvent aider à standardiser la configuration à travers les outils et les flux de travail.
Plan pilote de 14 jours
Jours 1 à 3 : Base
Choisissez 200 à 500 URL de produits à travers des détaillants faciles, modérés et difficiles. Mesurez le taux de succès, le taux de prix manquant, le taux de blocage, la latence et le CPSR.
Jours 4 à 7 : Test de route
Comparez les proxies de datacenter et résidentiels à travers les mêmes groupes de produits. Suivez quelle route produit le CPSR le plus bas avec une qualité de données acceptable.
Jours 8 à 10 : Test de rendu
Testez le rendu du navigateur uniquement sur les pages où l'extraction HTML ou JSON échoue. Mesurez si le coût plus élevé améliore la sortie valide.
Jours 11–14 : Validation et Alertes
Ajoutez des règles d'anomalie, des alertes d'erreur de parseur, des captures d'écran en cas d'échec, et des vérifications de région/devise. Finalisez les règles de routage par détaillant.
Ne scalez qu'après que le pilote ait produit une qualité de données stable.
Questions Fréquemment Posées
Qu'est-ce que la surveillance des prix en e-commerce ?
La surveillance des prix en e-commerce est la collecte et l'analyse automatisées des prix des produits, des promotions, de la disponibilité et des changements de prix régionaux auprès des détaillants et des places de marché en ligne.
Ai-je besoin de proxies pour la surveillance des prix ?
Pour des sources de données petites ou approuvées, ce n'est pas toujours nécessaire. Les proxies deviennent utiles lors de la surveillance à grande échelle, pour collecter des prix spécifiques à une région, réduire les blocages ou distribuer les demandes de manière responsable sur les sites cibles.
Quel type de proxy est le meilleur pour la surveillance des prix ?
Les proxies de datacenter sont utiles pour les listes et les cibles à faible friction. Les proxies résidentiels sont meilleurs pour les pages de détails des produits, les prix géo-spécifiques et les sites de vente au détail sensibles.
Dois-je utiliser des navigateurs sans tête ?
Seulement si nécessaire. Utilisez d'abord l'extraction HTML ou JSON. Utilisez des navigateurs sans tête lorsque les prix ou les promotions nécessitent un rendu JavaScript ou une interaction.
Comment savoir si les données de prix sont précises ?
Validez le prix, la devise, la disponibilité, le titre du produit, le SKU, la région et la structure de la page. Stockez l'URL source, l'horodatage, la version du parseur et les métadonnées de routage.
À quelle fréquence les prix doivent-ils être vérifiés ?
Cela dépend de la volatilité des produits. Les catalogues stables peuvent nécessiter des vérifications quotidiennes. Les produits compétitifs ou promotionnels peuvent nécessiter une surveillance horaire ou plus fréquente.
Comment réduire les coûts de surveillance ?
Segmentez les produits par valeur et volatilité, utilisez des routes moins chères pour les pages faciles, limitez le rendu du navigateur, fixez un plafond sur les tentatives et suivez le CPSR par détaillant et route.
Qu'est-ce qui cause des prix manquants ?
Les prix manquants peuvent provenir d'erreurs de parseur, de rendu JavaScript, de restrictions régionales, de portes de consentement, de pages CAPTCHA, de blocages doux ou de prix spécifiques à des variantes.
Dernières Pensées
La surveillance des prix en e-commerce n'est précieuse que si les données sont précises, opportunes et fiables. Un système qui collecte de nombreuses pages mais renvoie des prix manquants, obsolètes ou de mauvaise région crée plus de risques que de valeur.
L'infrastructure la plus solide utilise la méthode de collecte la plus simple et fiable, dirige le trafic intentionnellement, valide chaque résultat et mesure le coût par prix réussi. Utilisez des proxies de datacenter là où ils fonctionnent, des proxies résidentiels là où ils améliorent la fiabilité, et le rendu du navigateur uniquement lorsqu'il justifie son coût.
Pour les équipes qui développent des opérations d'intelligence des prix, connectez votre flux de travail de surveillance avec les cas d'utilisation de proxy de SquidProxies pour planifier le routage, la collecte de données et le contrôle des coûts autour des objectifs commerciaux réels.
Articles Connexes
MostLogin : Le navigateur anti-détection de premier plan pour une gestion multi-comptes fluide et une automatisation
MostLogin est un navigateur anti-détection conçu pour une gestion sécurisée de plusieurs comptes, l'isolement des profils de navigateur, l'intégration de proxies, l'automatisation et la collaboration en équipe. Il prend en charge des cas d'utilisation dans le commerce électronique, les réseaux sociaux, le marketing d'affiliation, la publicité et d'autres flux de travail multi-profils.
Surveillance du SEO local avec des proxies résidentiels : des résultats géographiques précis à grande échelle
Un guide pratique pour effectuer un suivi des SERP et des cartes avec une précision géographique en utilisant des proxies résidentiels. Découvrez l'architecture, les choix de routage, les métriques, les modes de défaillance et un cadre décisionnel conçu pour les agences, les marques et les équipes de données.
Proxies pour le suivi de classement SEO à grande échelle
Un guide pratique pour choisir, déployer et mesurer des proxies pour le suivi des classements SEO à volume élevé, avec une précision géographique fiable, de faibles taux de blocage et des coûts prévisibles.