 Chat en vivo
 Iniciar sesión


Etiquetado: web scraping18 artículos
Proxies de ISP Explicados: Cuándo Usarlos
Una guía práctica y centrada en la toma de decisiones sobre los proxies ISP. Aprende qué son, en qué superan a los proxies residenciales y de datacenter, los principales compromisos, consejos de implementación, métricas a seguir y escenarios del mundo real.
Proxies de Datacenter vs Residenciales vs ISP: Explicación
Aprenda cómo difieren los proxies de datacenter, residenciales y de ISP, cuándo usar cada uno, qué medir y cómo reducir bloqueos y costos en la recolección de datos y la automatización de producción.

Cómo los minoristas detectan el raspado de precios competitivos
Una guía práctica sobre cómo los minoristas detectan el scraping de precios, las señales y trampas que utilizan, y cómo los equipos de datos, SEO y precios pueden diseñar operaciones de scraping resilientes y medibles sin que los costos o las tasas de bloqueo se disparen.
Guía de Infraestructura para el Monitoreo de Precios en E-Commerce
Una guía práctica y basada en métricas para diseñar, operar y escalar la infraestructura de monitoreo de precios en e-commerce para equipos de marketing, SEO y datos.
Construyendo Pipelines de Entrenamiento de IA con Infraestructura de Proxy
Una guía práctica para diseñar pipelines de entrenamiento de IA con infraestructura de proxy: arquitectura, selección de proxies, estrategias de enrutamiento, métricas, compensaciones de costos y modos de falla. Incluye marcos de decisión, escenarios del mundo real y preguntas frecuentes para equipos técnicos y de negocios.
Técnicas de Evitación de CAPTCHA para la Automatización del Navegador
Estrategias prácticas y centradas en el cumplimiento para reducir la fricción de CAPTCHA en la automatización del navegador. Aprenda a diseñar sesiones, moldear el tráfico, elegir proxies y monitorear las métricas adecuadas para aumentar la tasa de éxito y reducir el costo por solicitud exitosa.
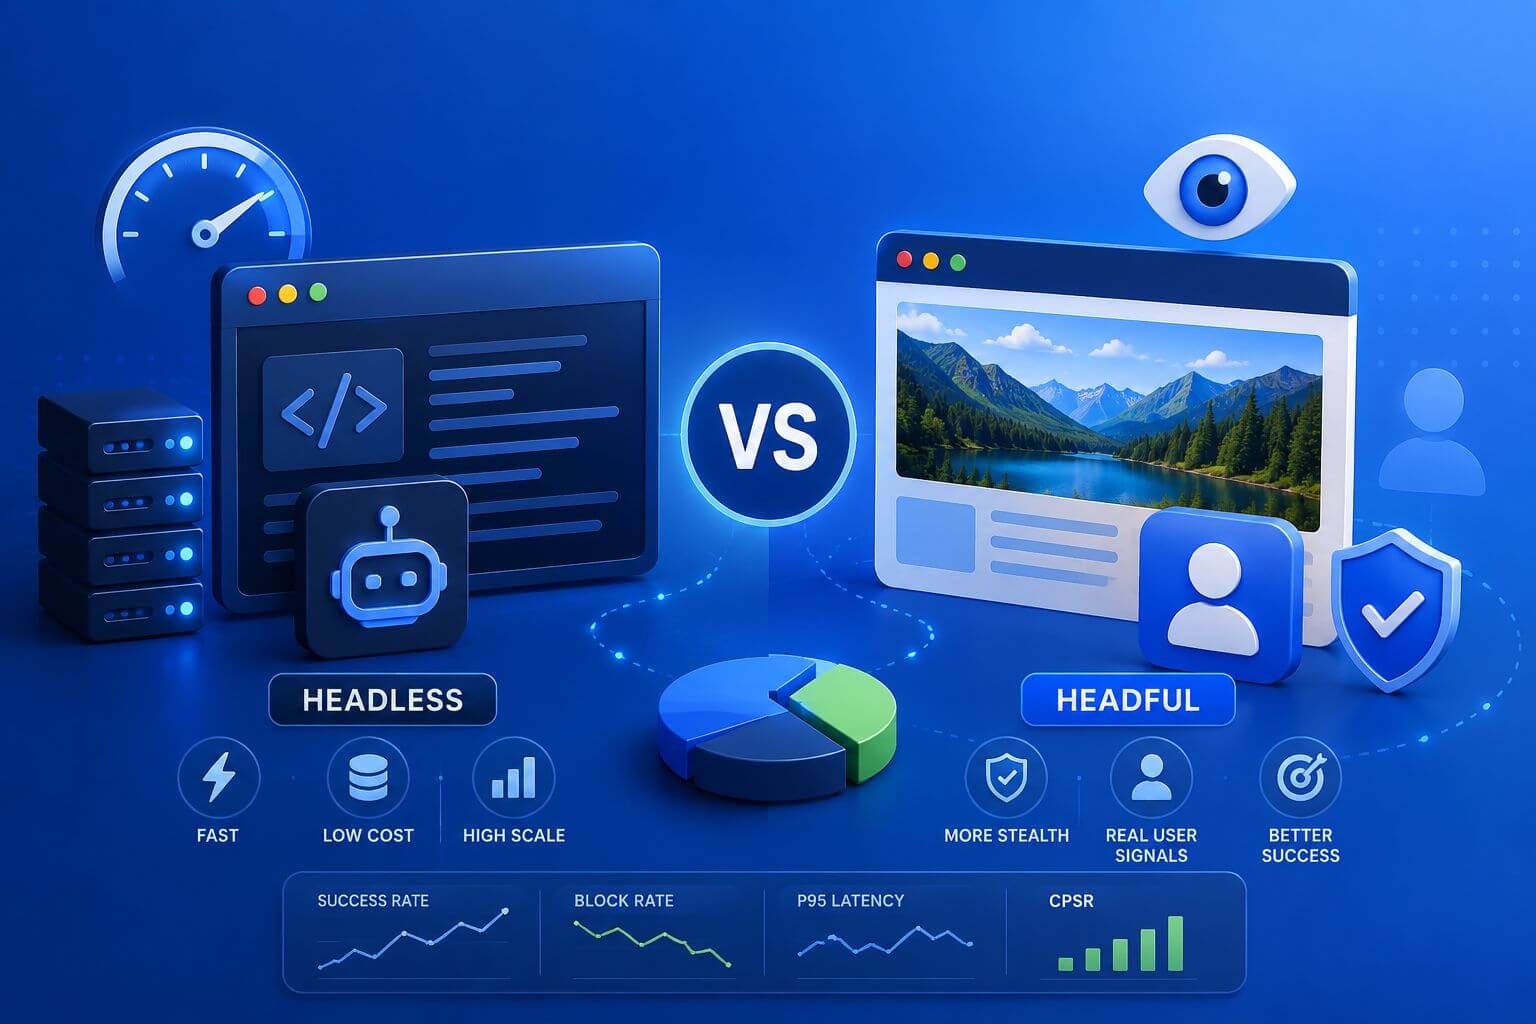
Navegadores sin cabeza vs Navegadores con cabeza en el raspado moderno: Cómo elegir
Una guía práctica y basada en métricas para elegir entre navegadores sin cabeza y con cabeza para el scraping web moderno, con marcos de decisión, escenarios del mundo real, consejos de ajuste y qué medir.
Huella Digital del Navegador para la Extracción de Datos: Lo que los Proxies Pueden y No Pueden Solucionar
Una guía práctica sobre la huella digital del navegador en la recolección de datos web y los problemas exactos que los proxies pueden y no pueden resolver. Incluye marcos de decisión, modos de fallo, métricas a monitorear y escenarios del mundo real para equipos que realizan scraping, automatización y recolección de datos a gran escala.
Explicación del Fingerprinting del Navegador para Scrapers
Aprenda cómo la huella digital del navegador afecta el scraping web moderno y por qué los proxies por sí solos no son suficientes para una automatización estable. Esta guía explica las señales del navegador como el agente de usuario, WebRTC, canvas, zona horaria y comportamiento de sesión, junto con estrategias prácticas para reducir CAPTCHA, bloqueos suaves, desajustes geográficos y sesiones de navegador inestables a gran escala.
Mejor Configuración de Proxy para Automatización con Playwright
Aprende a construir la mejor configuración de proxy para la automatización de Playwright utilizando proxies residenciales y de datacenter, sesiones persistentes, contextos de navegador y estrategias de rotación inteligente. Esta guía práctica explica cómo reducir las tasas de bloqueo, mejorar la estabilidad de las sesiones, optimizar la concurrencia y disminuir el CPSR para flujos de trabajo de automatización de navegadores y scraping web a gran escala.
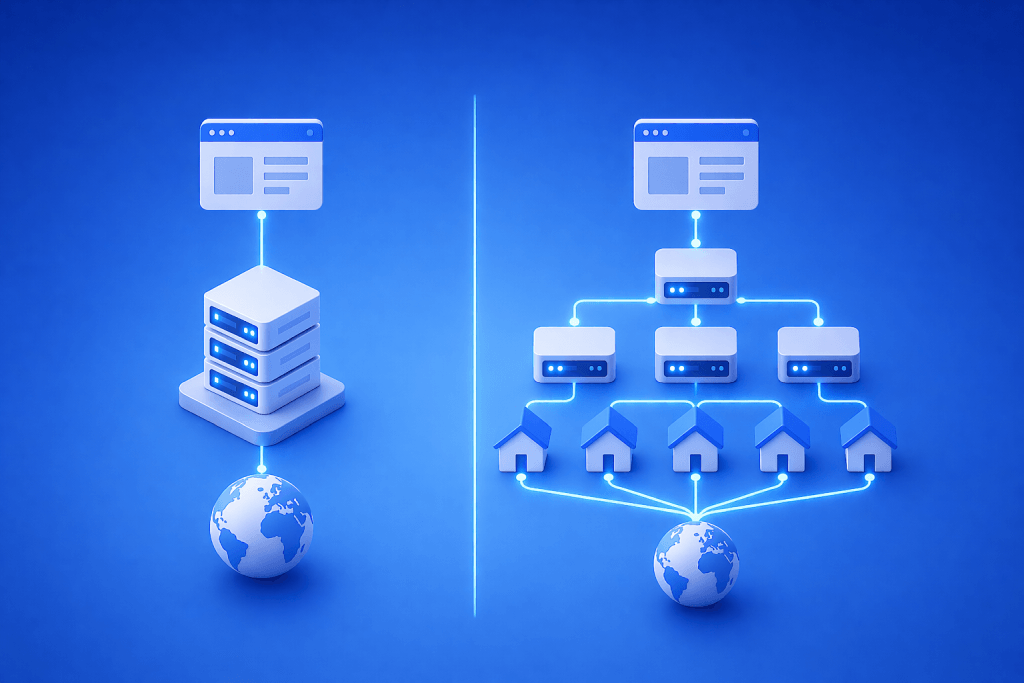
Estabilidad del Scraper: Diferencias entre Proxy de Desarrollo y Proxy de Producción
Por qué los scrapers funcionan en desarrollo pero fallan en producción, cómo cambian los proxies a gran escala y cómo diseñar rutas, rotaciones y métricas estables que reduzcan fallos y costos.
Evitando cuellos de botella en la recolección de datos con proxies
Una guía práctica para eliminar los retrasos en la recolección de datos al hacer coincidir los tipos de proxy con las cargas de trabajo, ajustar la rotación y la concurrencia, y monitorear la tasa de bloqueo y CPSR. Diseñada para SEO, comercio electrónico, viajes, finanzas y equipos de datos.
Recolección de Datos a Gran Escala: Mejores Prácticas de Infraestructura
Una guía práctica para diseñar, ejecutar y mejorar sistemas de recolección de datos a gran escala. Aprenda sobre diseño de redes, arquitectura de scraping, controles de calidad, cumplimiento y palancas de costos para tuberías confiables.
Diversidad de ASN: Por Qué Es Importante en la Infraestructura de Proxies
Una guía práctica y centrada en la producción sobre la diversidad de ASN en la infraestructura de proxies: qué es, por qué reduce los bloqueos, cómo planificar tu mezcla de ASN y cómo validarla y monitorearla en cargas de trabajo reales de scraping y automatización.
Arquitectura de Pool de Proxies para la Recolección de Datos de Alto Volumen
Una guía práctica y de calidad de producción para diseñar, escalar y monitorear una arquitectura de grupo de proxies para la recolección de datos web de alto volumen, con KPIs claros, estrategias de rotación y marcos de decisión.
Estrategias de Rotación de Proxies: Cómo Reducir Bloqueos Sin Romper Sesiones
Una guía práctica y de calidad de producción sobre estrategias de rotación de proxies que reducen bloqueos, mantienen el estado de sesión y escalan la recolección de datos. Cubre políticas de rotación, tipos de proxies, marcos de decisión, señales de monitoreo, trampas y preguntas frecuentes para operadores e ingenieros.
Errores 403, 429 y CAPTCHA: Cómo diagnosticar bloqueos de proxy
Una guía práctica y de calidad para diagnosticar y solucionar errores 403, 429 y CAPTCHA en la extracción de datos y la automatización. Aprenda a identificar las causas raíz, elegir la mezcla de proxies adecuada, establecer límites de velocidad e instrumentar su pila para mantener las tasas de bloqueo bajo control.
Los Beneficios de los Proxies Rotativos
Descubre cómo los proxies rotativos mejoran la fiabilidad, la escalabilidad, la geo-localización y la resistencia a prohibiciones para la recolección ética de datos, SEO y flujos de trabajo de verificación.