 Live Chat
 Mag-log In


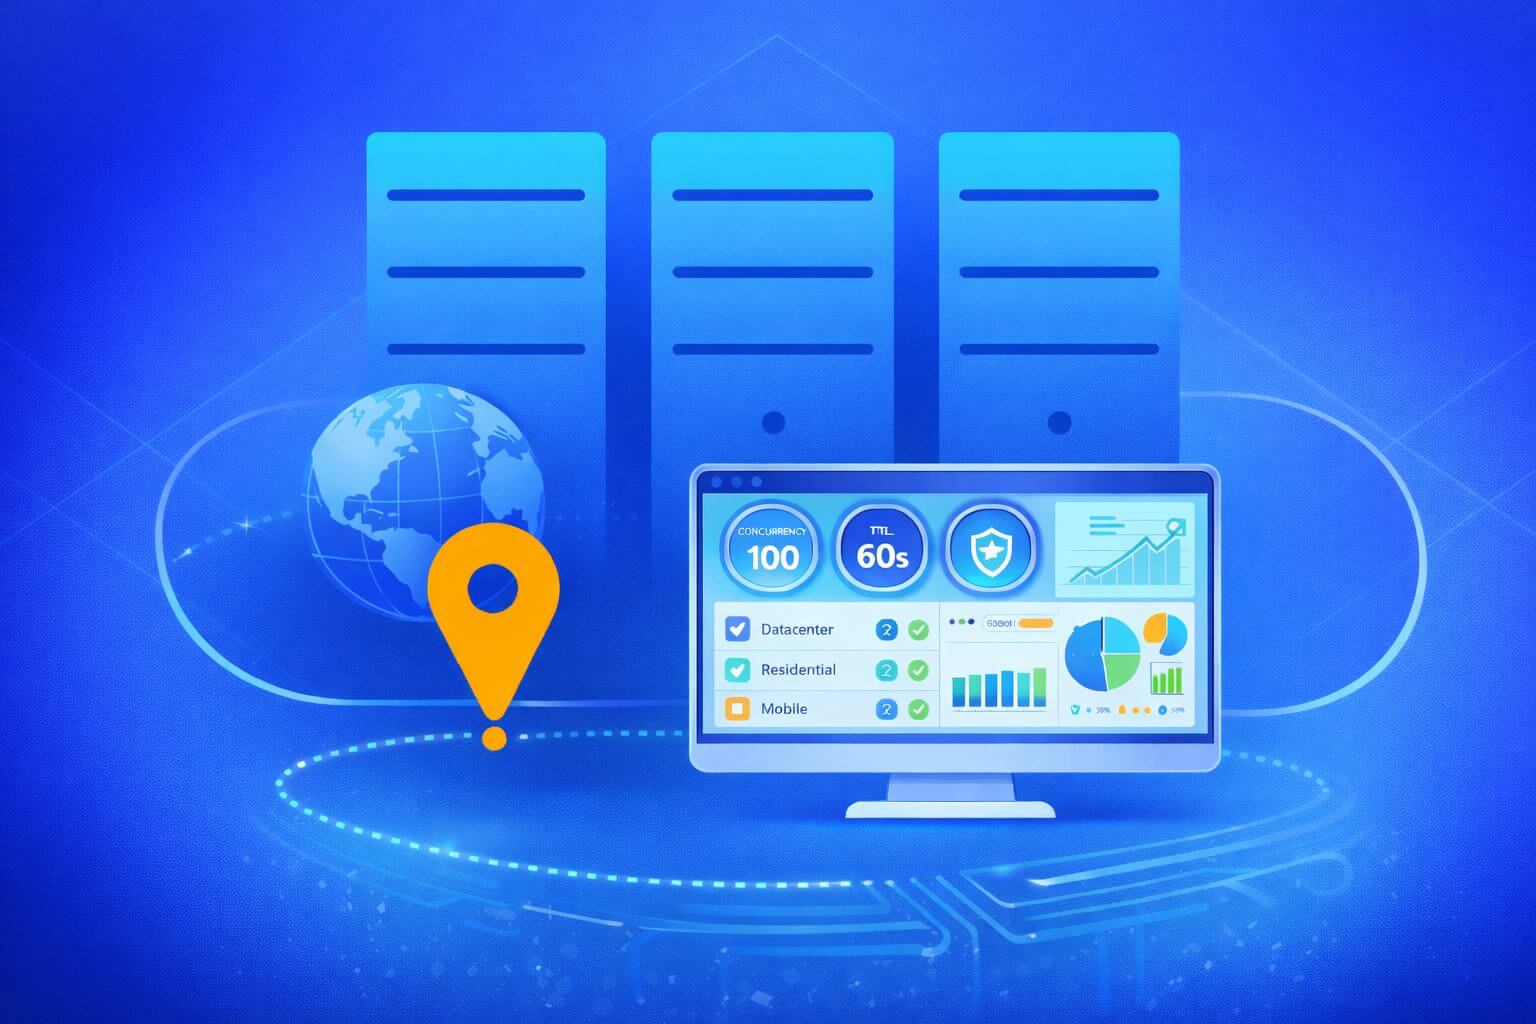
Pamamahala ng Proxy Pools sa Malakihan: Concurrency, TTL, at Disenyo ng Failover
Pamamahala ng Proxy Pools sa Malakihan: Concurrency, TTL, at Disenyo ng Failover
Ang mga scrapers at automations ay nabibigo sa mga mahal, tahimik na paraan: tumataas na block rates, throttled sessions, o maingay na retries na nagdodoble sa iyong gastos. Kapag nangyari iyon, ang ugat na sanhi ay madalas na mahina ang pamamahala ng proxy pool: sobrang agresibong concurrency, sticky sessions na nauubos, o brittle failover. Sa dulo, malalaman mo kung paano magdisenyo, subukan, at subaybayan ang mga pool na talagang lumalaki.
Ang pamamahala ng proxy pool ay ang disiplina ng pagkontrol kung gaano karaming mga request ang dala ng bawat IP, gaano katagal nabubuhay ang mga session (TTL), at kung gaano kabilis ang traffic na lumilipat sa mga malusog na ruta. Kung maganda ang pagkakagawa mo, mababawasan mo ang block rate, madadagdagan ang matagumpay na requests bawat dolyar, at mababawasan ang engineering churn. Kung hindi, mukhang abala ang sistema pero nagbibigay ng masamang data.
Ano ang pamamahala ng proxy pool?
Ang pamamahala ng proxy pool ay nag-uugnay ng IP rotation, per-target concurrency, session TTL, at failover logic upang mapanatili ang mataas na success rates sa ilalim ng anti-bot pressure. Sa praktika, nangangahulugan ito ng pagtatakda ng mga guardrails (mga limitasyon at timeouts), pagsukat ng kalusugan, at pag-aangkop ng traffic sa halos real time. Ito ang backbone ng maaasahang scraping at automation sa malakihan.
Kung nagbabalak ka ng bagong programa o nagpapalawak ng umiiral, tingnan ang mga karaniwang use cases ng proxy upang ma-anchor ang mga inaasahan at edge cases na makikita mo sa produksyon. Tingnan ang mga halimbawa sa pricing monitors, travel inventory, at social listening sa aming proxy use cases library.
Concurrency: itulak ang throughput, hindi ang iyong swerte
Ang concurrency ay kung gaano karaming in-flight requests ang pinapayagan mo bawat IP, bawat target, o bawat session. Kung masyadong mataas, makakakuha ka ng blocks at captchas. Kung masyadong mababa, mawawalan ka ng SLAs.
Isang magandang panimulang modelo:
- I-cap ang concurrency bawat IP at bawat domain. Mga halimbawa ng target na dapat i-validate sa isang pilot: 1–3 concurrent requests bawat IP bawat domain.
- Gumamit ng global token bucket upang hubugin ang mga bursts sa buong fleet. Pinipigilan nito ang stampedes pagkatapos ng retries o scheduler spikes.
- Magdagdag ng adaptive backoff. Dagdagan ang inter-request delay sa soft blocks (429/5xx), pagkatapos ay bumaba kapag bumuti ang tagumpay.
Isang simpleng sizing formula:
- Effective concurrency = healthy_proxies × sessions_per_proxy × concurrency_per_session.
- Sa simpleng salita: kung gaano karaming malinis na lane ang mayroon ka na pinarami ng kung gaano karaming sasakyan ang pinapayagan mong pumasok sa bawat lane.
I-validate ang iyong mga setting gamit ang maiikli at maingat na runs bawat target. Subaybayan ang success rate, median response time, at captcha incidence bago ka mag-scale up.
TTL at session strategy: manatili kapag nakakatulong, mag-rotate kapag nakakasama
Ang TTL (time to live) ay kung gaano katagal mong pinapanatiling sticky ang isang session o IP para sa isang target. Ang sticky sessions ay nakakatulong sa mga login flows, carts, o pag-paginate ng mga listahan. Ang rotation ay nakakatulong sa mga pampublikong pahina na nagpaparusa sa mga paulit-ulit na hits.
Praktikal na gabay:
- Gumamit ng sticky sessions kung saan mahalaga ang estado (auth, checkout, deep pagination).
- Itakda ang TTL batay sa panganib ng target. Mga halimbawa ng target na dapat i-validate sa isang pilot: 1–5 minuto para sa stateful flows; 10–60 segundo para sa mga pampublikong pahina sa ilalim ng katamtamang pressure.
- I-refresh ang TTL sa tagumpay lamang; mag-expire nang agresibo sa soft o hard blocks.
- Mag-rotate ng user-agents at minimal headers kasama ang session. Panatilihing pareho ang iyong fingerprint sa loob ng sticky window upang maiwasan ang pagdududa.
Paalaala sa gitna ng artikulo: ang matibay na pamamahala ng proxy pool ay itinuturing ang TTL bilang isang control knob, hindi isang checkbox. I-tune mo ito bawat domain sa paglipas ng panahon.
Disenyo ng failover na talagang nakakabawi
Dapat mabilis, lokal, at may kamalayan sa uri ng error ang failover. Ang bulag na global retries ay maaaring magpalala ng blocks at gastos.
Praktikal na mga hakbang sa failover:
- I-classify ang mga error nang mabilis. 4xx mula sa anti-bot? Palitan ang IP at dagdagan ang backoff. Connection timeouts? Subukan ang ibang exit sa parehong ASN o rehiyon. 5xx? Bumagal at subukan muli na may jitter.
- Gumamit ng circuit breaker bawat target at bawat exit pool. Mag-trip sa tumataas na failure rate o latency. Kapag bukas, i-route sa isang pangalawang pool.
- Panatilihin ang maraming pools batay sa geo at uri ng IP, na may warm capacity. Ang cold starts sa panahon ng mga insidente ay nagdudulot ng mas maraming pagkabigo.
- I-cache ang target DNS at pre-test ang TLS upang mabawasan ang handshake failures sa panahon ng switchover.
Kapag umaasa ka sa bilis at throughput, ang mga low-latency pools ay nagbibigay ng halaga. Kung iyon ang iyong workload, suriin ang mga kakayahan na karaniwan sa datacenter proxies at kung paano sila kumikilos sa ilalim ng bursty traffic.
Komposisyon ng Pool: piliin ang tamang uri ng IP para sa trabaho
- Datacenter IPs: mabilis, cost-efficient, predictable latency. Pinakamainam para sa pampublikong nilalaman at APIs na may maluwag na kontrol sa bot. Mag-ingat sa mga ASN-level na block.
- Residential IPs: mas mataas na tiwala sa mga consumer sites; mas mabuti para sa stealth at iba't ibang geos. Asahan ang mas mataas na gastos at variable na last-mile latency.
- Mobile IPs: niche na paggamit para sa mga high-friction na target; kadalasang may limitadong throughput at mas mataas na presyo.
Bumuo ng iyong fleet batay sa iyong mga target:
- Magsimula sa datacenter para sa bilis at gastos. Magdagdag ng residential kung saan ang block rate ay nananatiling mataas pagkatapos i-tune ang concurrency at TTL.
- Panatilihing malapit ang mga geos sa user base ng target. I-validate ang geo accuracy sa mga log.
- Panatilihin ang hiwalay na pools batay sa risk profile upang ihiwalay ang reputasyon.
Blueprint ng Implementasyon (language-agnostic)
Narito ang isang compact control loop upang i-adapt ang load at makabawi mula sa mga pagkabigo.
loop tick=100ms:
  for target in targets:
    health = metrics[target]
    if health.cpsr < SLO_CPSR or health.block_rate > SLO_BLOCK:
      reduce(target.global_tokens, factor=0.8)
      shorten(target.ttl, floor=10s)
      open_circuit_if_needed(target)
    else if health.success_rate > target.prev_success:
      increase(target.global_tokens, step)

  for worker in idle_workers:
    target = scheduler.next_target()
    proxy  = pool.acquire(target.geo, type=target.ip_type)
    session = session_store.get_or_create(proxy, target, ttl=target.ttl)
    dispatch(request, proxy, session, headers=fingerprint(session))

on_response(resp):
  if is_soft_block(resp): mark_proxy(proxy, warmdown=60s); rotate_session()
  if is_hard_block(resp): quarantine(proxy); escalate_ip_type()
  record_metrics()
Mga pangunahing ideya: hubugin ang mga global tokens, paliitin ang TTL sa ilalim ng pressure, trip circuits sa pagtaas ng blocks, at i-escalate ang uri ng IP lamang kapag nabigo ang mas murang knobs.
Monitoring at SLOs na Mahalaga
Subaybayan ang mga signal na direktang nakatali sa mga resulta:
- CPSR (connection success rate) at HTTP success rate ayon sa target at uri ng IP.
- Mga block indicators: mga captcha na nakita, 403/429 ratios, bilang ng WAF challenge.
- Latency P50/P95, queue depth, retry percentage.
- Geo accuracy, ASN diversity, at IP reuse/burn rate.
- Session stability: average lifetime at mga request bawat session bago ang pagkabigo.
Mag-alerto kapag:
- Ang block rate ay tumaas ng > X% sa loob ng N minuto (halimbawa ng target na i-validate: 20% sa loob ng 10 minuto).
- Ang CPSR ay bumaba sa ibaba ng threshold (halimbawa: < 95% na tuloy-tuloy sa loob ng 5 minuto).
- Ang circuit breakers ay bukas ng higit sa M minuto nang walang recovery.
Dalawang Real-World na Senaryo
-
Price monitoring sa 500 RPS: Datacenter pool na may per-IP concurrency = 2, TTL = 30s. Sa ilalim ng mid-day block spike, ang sistema ay nag-cut ng tokens ng 30%, nag-rotate ng sessions sa 429s, at nagbukas ng circuit sa isang maliit na residential pool para sa retry tier lamang. Ang block rate ay nag-stabilize sa loob ng 5 minuto.
-
Logged-in travel scraping: Sticky sessions (TTL = 3 minuto) para sa mga account pages na may cart state. Concurrency = 1 bawat session. Ang breaker ay nag-trip sa captcha floods, na nagpipilit ng rotation at 60s cool-off bawat proxy. Ang data freshness ay nananatili, at ang mga account ay nakakaiwas sa lockouts.
Mag-ingat sa mga Ito
- Walang katapusang retries sa 403/429. Masusunog mo ang mga IP at tataas ang gastos. I-classify at mag-back off.
- Isang shared pool para sa lahat ng target. Ang isang mahigpit na site ay maaaring makasira sa reputasyon ng iba.
- Over-sticky sessions. Maganda para sa state, masama para sa reputasyon. Mag-rotate nang mas maaga sa soft blocks.
- Walang warm standby capacity. Ang failover na nag-spin up ng cold pools ay hindi failover.
- Pagwawalang-bahala sa consistency ng header. Kung masyadong nagbabago sa pagitan ng mga request, mukhang robotic ka; kung walang pagbabago sa loob ng maraming oras, mukhang kahina-hinala ka.
Mabilis na Tulong sa Desisyon: default knobs para simulan ang mga pilot
| Sitwasyon | Concurrency per IP | Session TTL | Unang Hakbang sa Failover |
|---|---|---|---|
| Pampublikong katalogo, katamtamang kontrol | 1–3 | 10–30s | I-rotate ang IP, magdagdag ng 200–500ms jitter |
| Authenticated/cart flows | 1 | 2–5m | Panatilihing sticky; palitan ang IP lamang sa mga hard blocks |
| Mataas na friction target | 1 | 20–60s | Tripin ang breaker nang maaga; i-escalate ang uri ng pool |
Gamitin ang mga ito bilang mga halimbawa ng mga target upang i-validate sa isang pilot, pagkatapos ay i-tune ayon sa domain.
Mga Gastos, Pagsunod, at ROI
Ang layunin ng negosyo ay mas mababang gastos sa bawat matagumpay na request. Subaybayan ito kasabay ng pagsisikap ng engineering.
Mga Tip:
- Gumastos kung saan ito nagbabayad. Kung ang datacenter na may maingat na concurrency ay nakakatugon sa iyong SLA, manatili doon. I-escalate ang uri ng IP lamang kapag ang mga block-adjusted na gastos ay nangangailangan nito.
- Maglaan ng oras at compute para sa mga quality checks. Ang pag-uulit ng masamang data ay mas mahalaga kaysa sa pagpigil dito.
- Panatilihin ang mga region-specific pools para sa data residency o mga contractual limits. I-dokumento kung aling mga target ang nangangailangan ng pahintulot ng user, paggalang sa robots.txt, o legal na pagsusuri.
Para sa konteksto ng pagba-budget at SKU planning, tingnan ang aming mataas na antas na plans and pricing overview at i-align ang volume tiers sa iyong inaasahang CPSR.
Mga Madalas na Itanong
Ilang proxies ang kailangan ko para sa 1,000 requests bawat minuto?
Tantiyaing bumalik mula sa per-IP concurrency at success rate. Kung nagpatakbo ka ng 2 sabay-sabay na requests bawat IP at umaasa ng 90% na tagumpay, magsimula sa paligid ng 600–700 IPs, pagkatapos ay i-tune pababa habang itinaas mo ang CPSR. I-validate gamit ang 10–15 minutong pilot bawat target.
Anong TTL ang dapat kong gamitin para sa login-required scraping?
Panatilihing sticky ang mga session nang sapat na mahaba upang maiwasan ang mga re-auth flows, kadalasang 2–5 minuto. Pabilisin ang TTL sa mga palatandaan ng pressure (captcha, 429s), at i-refresh lamang sa mga matagumpay na requests. Tratuhin ang bawat domain nang hiwalay at i-tune sa paglipas ng panahon.
Dapat ko bang pagsamahin ang datacenter at residential proxies sa isang pool?
Panatilihin silang bilang mga hiwalay na pools na nakatali sa mga failover tiers. I-route ang baseline traffic sa cost-effective na pool (madalas na datacenter) at i-reserve ang residential para sa mga retries o mataas na friction paths. Ito ay nag-iisa ng reputasyon at nagpapalinaw ng gastos.
Paano ko madidetect kung kailan ko dapat i-trip ang circuit breaker?
Gumamit ng rolling windows bawat target. I-trip kung ang CPSR ay bumaba sa ilalim ng isang threshold o kung ang block rate ay tumaas lampas sa iyong tolerance sa loob ng N minuto. Magdagdag ng half-open state upang subukan ang recovery gamit ang maliit na traffic bago ganap na isara.
Bakit nakikita ko pa rin ang mga captcha pagkatapos i-rotate ang mga IP?
Maaaring ginagamit mo ang parehong ASN, nagdadala ng agresibong headers, o tumama sa target-side rate limits. I-randomize ang mga honest browser headers bawat session, magdagdag ng jitter sa pagitan ng mga requests, at dagdagan ang ASN diversity. Suriin kung ang iyong mga proxies ay nagbabahagi ng subnets na ang target ay itinuturing nang mapanganib.
Anong mga metrics ang nagpapatunay na ang mga pagbabago ko ay nagpabuti ng pagiging maaasahan?
Tumingin para sa mas mataas na CPSR, mas mababang block rate, at pagbaba ng retries bawat tagumpay. Ang latency p95 ay dapat na mag-stabilize o bumaba. Ang pinaka-nagsasalita ay ang gastos bawat matagumpay na request, na dapat na bumaba pagkatapos ng tuning.
Paano ko mapapanatiling kontrolado ang panganib ng pagsunod?
Panatilihin ang mga target-level policies para sa pahintulot, mga termino, at mga kategorya ng data. I-log ang geo at uri ng IP na ginamit bawat request. Limitahan ang scraping ng personal na data maliban kung ang iyong legal team ay nasuri ang use case at mga kontrol.
Sapat na ba ang pag-rotate ng user-agents upang maiwasan ang mga blocks?
Hindi. Nakakatulong ito, ngunit ang mga domain ay nagmamasid sa timing, mga pattern ng path, at mga error-driven retries. I-pair ang UA rotation sa per-IP concurrency caps, session TTL controls, at domain-aware backoff.
Pagsasama-sama
Ang epektibong pamamahala ng proxy pool ay pinagsasama ang tatlong control loops: tame concurrency, right-size TTL, at mabilis na fail over nang hindi nag-thrash. Ang tradeoff ay bilis laban sa reputasyon: itulak nang sapat upang matugunan ang SLAs, ngunit i-rotate at palamigin bago ka makakuha ng atensyon.
Mga susunod na hakbang:
- Patakbuhin ang isang 30–60 minutong pilot bawat domain na may mga konserbatibong default, pagkatapos ay palawakin.
- I-instrument CPSR, block rate, retries bawat tagumpay, at session lifetime ayon sa pool.
- Subukan ang breaker thresholds, TTL decay sa ilalim ng pressure, at per-IP concurrency caps.
Para sa mas malalim na mga pattern at detalye ng implementasyon, tingnan ang aming mga teknikal na guides. Sa maayos na pamamahala ng proxy pool, maaari mong maabot ang mga layunin sa throughput, mapanatili ang mataas na kalidad ng data, at kontrolin ang mga gastos nang hindi kinakailangang mag-firefight bawat linggo.
Mga Kaugnay na Artikulo
Rotating vs Static Proxies: Performance Tradeoffs
Isang praktikal at desisyon-nakatutok na gabay na nagkukumpara sa rotating at static proxies. Alamin kung paano nakakaapekto ang bawat isa sa success rate, block rate, latency, cost, at kalidad ng data. Kasama ang isang selection framework, tuning tips, failure modes, at mga measurable metrics para sa scraping, automation, at analytics teams.
Mobile Proxies vs Residential Proxies: Isang Praktikal na Gabay sa Pagbili at Paggawa
Isang praktikal na paghahambing ng mobile at residential proxies para sa scraping, ads, at automation. Alamin kung kailan dapat gamitin ang bawat isa, kung paano sila gumagana, ano ang dapat sukatin, mga failure modes, at isang framework sa pagdedesisyon upang mabawasan ang block rates at mapabuti ang ROI.
ISP Proxies Explained: Kailan Mo Dapat Gamitin Ito
Isang praktikal na gabay na nakatuon sa desisyon tungkol sa ISP proxies. Alamin kung ano ang mga ito, kung saan sila mas mahusay kaysa sa residential at datacenter proxies, mga pangunahing tradeoff, mga tip sa deployment, mga metrics na dapat subaybayan, at mga totoong senaryo.