 Live Chat
 Mag-log In


Pagbuo ng AI Training Pipelines gamit ang Proxy Infrastructure
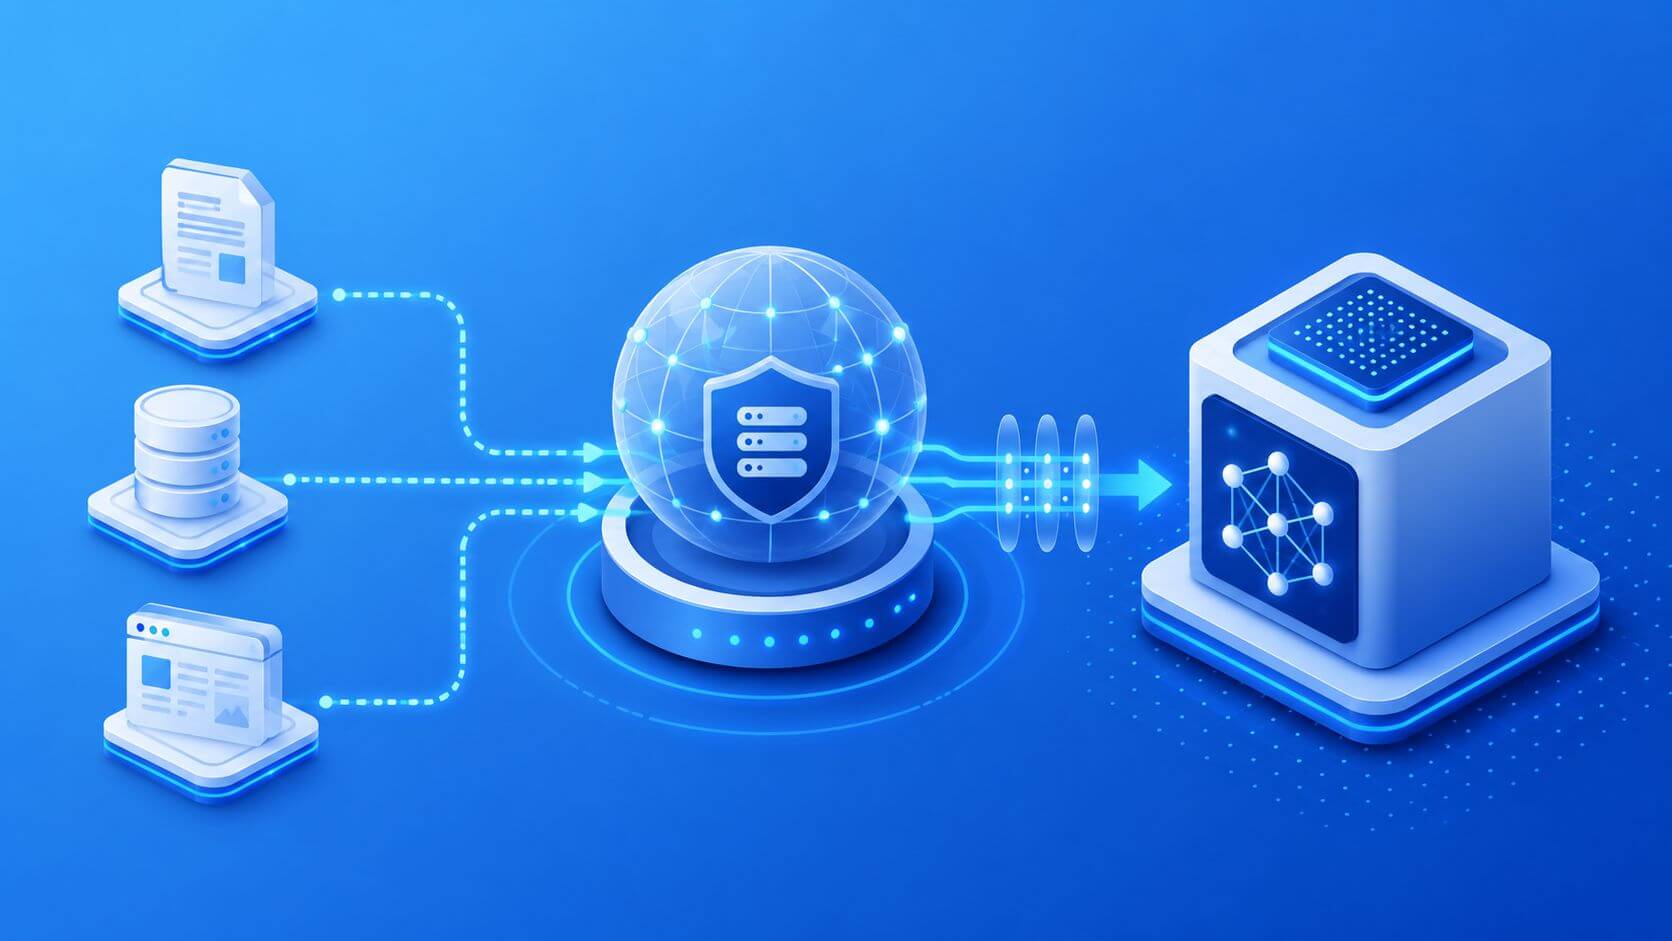
Ang mga AI model ay umaasa sa sariwa, iba-iba, at representatibong data. Kapag ang training data ay nagiging luma, limitado sa rehiyon, duplicated, o biased sa isang makitid na set ng source, bumababa ang kalidad ng model. Kasabay nito, ang malakihang koleksyon ng data ay maaaring makatagpo ng mga rate limit, geo restrictions, blocked sessions, inconsistent responses, at incomplete datasets.
Dito pumapasok ang proxy infrastructure bilang bahagi ng AI data pipeline. Para sa mga team na kumokolekta ng public web data, nagmo-monitor ng regional content, o nagre-refresh ng datasets para sa model training, proxies for data for AI ay makakatulong upang mapabuti ang coverage, bawasan ang mga gaps sa koleksyon, at suportahan ang mas maaasahang operasyon ng data kapag ginamit ng tama.
Ang pagbuo ng AI training pipelines gamit ang proxy infrastructure ay nangangahulugang pagdidisenyo ng collection layer upang ang mga request ay ma-route sa tamang uri ng IP, rehiyon, session policy, at validation rules para sa bawat source. Ang layunin ay hindi lamang mangolekta ng mas maraming data. Ang layunin ay mangolekta ng magagamit, compliant, maayos na na-label, at paulit-ulit na data sa isang predictable na halaga.
Bakit Mahalaga ang Proxy Infrastructure para sa AI Training Data
Nabibigo ang AI training pipelines kapag ang data layer ay hindi maaasahan.
Kadalasang mga problema ay kinabibilangan ng:
- nawawalang records mula sa blocked requests
- biased datasets mula sa limitadong geographic coverage
- luma na content dahil hindi natatapos ang crawls sa takdang oras
- duplicate o malformed records mula sa retry-heavy collection
- inconsistent pricing, language, o regional content
- tumataas na infrastructure spend nang walang mas magandang kalidad ng data
Ang isang proxy layer ay tumutulong sa pamamagitan ng pagbibigay sa data collection system ng higit na kontrol sa network identity, lokasyon, session continuity, at request distribution.
Halimbawa, ang isang model na sinanay sa eCommerce product data ay maaaring kailanganin ng mga presyo, availability, descriptions, reviews, at category structures mula sa maraming rehiyon. Kung lahat ng koleksyon ay nagmumula sa isang bansa, maaaring mawalan ang dataset ng localized prices, shipping rules, regional product names, o pagkakaiba sa availability.
Ang paggamit ng isang structured proxy strategy ay nagpapahintulot sa mga team na mangolekta ng mas representatibong data habang nagmo-monitor ng success rate, block rate, geo accuracy, at cost per successful request.
Ano ang Hitsura ng isang AI Training Pipeline
Ang isang production AI training pipeline ay karaniwang may ilang yugto:
- Source discovery — tukuyin ang mga domain, feeds, APIs, pages, o datasets.
- Collection — kunin ang data sa pamamagitan ng HTTP clients, browser automation, o approved APIs.
- Validation — suriin ang schema, completeness, language, region, at duplication.
- Cleaning — i-normalize ang mga fields, alisin ang noise, deduplicate, at i-filter ang sensitive data.
- Labeling o enrichment — magdagdag ng mga kategorya, entities, tags, embeddings, o metadata.
- Versioning — itago ang mga snapshots upang ang model training ay ma-reproduce.
- Training at evaluation — ipasok ang curated data sa model workflows.
- Monitoring — subaybayan ang drift, kalidad, freshness, at pipeline reliability.
Ang proxy infrastructure ay kadalasang nasa collection layer, ngunit ito ay nakakaapekto sa lahat ng downstream. Kung ang koleksyon ay hindi matatag, ang bawat susunod na yugto ay nagiging mas mahal.
Core Architecture para sa Proxy-Aware AI Data Pipelines
Ang isang malakas na architecture ay naghihiwalay ng collection logic mula sa proxy routing logic.
Ang isang praktikal na sistema ay kinabibilangan ng:
- Scheduler — nagdedesisyon ng crawl frequency, priority, at collection windows.
- Fetcher layer — gumagamit ng HTTP clients, web scraping proxies, o browser automation.
- Proxy manager — pumipili ng uri ng proxy, rehiyon, rotation policy, at session rules.
- Domain policy registry — nag-iimbak ng mga pinapayagang ruta, concurrency limits, at compliance notes.
- Validation layer — suriin kung ang ibinalik na data ay kumpleto at magagamit.
- Storage layer — nag-iimbak ng raw at processed data na may timestamps at lineage.
- Monitoring layer — nagmo-monitor ng success rate, block rate, latency, retry depth, at CPSR.
Ang isang pinadaling daloy ay mukhang ganito:
Scheduler
   ↓
Domain Policy
   ↓
Fetcher / Browser Worker
   ↓
Proxy Manager
   ↓
Target Source
   ↓
Validation
   ↓
Storage + Lineage
   ↓
Training Dataset
Ang proxy manager ay hindi dapat basta-basta magpalit ng IP nang walang konteksto. Dapat itong gumawa ng mga desisyon sa routing batay sa domain, uri ng workload, rehiyon, mga kinakailangan sa session, gastos, at kasaysayan ng mga kamakailang pagkabigo.
Pumili ng Tamang Uri ng Proxy para sa Pagkolekta ng AI Data
Iba't ibang mga trabaho sa pagkuha ng data ang nangangailangan ng iba't ibang uri ng proxy.
Datacenter proxies ay kadalasang magandang pagpipilian para sa mataas na dami ng koleksyon mula sa mga pampublikong pahina na may mababang hadlang. Mabilis sila, predictable, at cost-efficient kapag ang mga target ay hindi nangangailangan ng mga signal ng network na katulad ng sa consumer.
Residential proxies ay mas angkop para sa mga geo-sensitive, dynamic, o mga pahinang nakaharap sa consumer kung saan ang pagkakakilanlan ng network ay nakakaapekto sa kung anong nilalaman ang ibinabalik.
Isang praktikal na gabay sa pagpili ng proxy:
| Workload | Inirerekomendang Uri ng Proxy | Bakit |
|---|---|---|
| Pampublikong static na pahina | Datacenter proxies | Mabilis at cost-efficient |
| Mga katalogo ng produkto | Datacenter muna, residential na fallback | Pinapanatili ang mababang gastos habang pinapanatili ang saklaw |
| Localized pricing | Residential proxies | Mas mabuti para sa mga resulta na tiyak sa rehiyon |
| Data ng paglalakbay o marketplace | Residential proxies | Tumutulong sa dynamic, geo-sensitive na nilalaman |
| Multi-step na browsing flows | Sticky residential sessions | Pinapanatili ang continuity ng session |
| Mataas na hadlang na mga mapagkukunan | Residential o maingat na kontroladong mga session ng browser | Pinapabuti ang tagumpay sa mga sensitibong pahina |
| API-like endpoints | Datacenter o direktang aprubadong access | Mas mababang gastos at mas simpleng routing |
Ang pinakamahusay na diskarte ay kadalasang hybrid. Gumamit ng pinakamababang gastos na ruta na nagbabalik ng wastong data, pagkatapos ay mag-escalate lamang kapag ipinapakita ng mga metric na kinakailangan ito.
Kailan Nakakatulong ang Proxy Infrastructure—at Kailan Hindi
Nakakatulong ang proxy infrastructure kapag ang problema ay may kaugnayan sa access sa network, reputasyon ng IP, rehiyon, o session routing.
Gumamit ng proxies kapag:
- ang mga mapagkukunan ay nagbabalik ng iba't ibang data batay sa bansa o lungsod
- ang mga crawl ay may rate-limited batay sa IP
- ang nilalaman ay localized batay sa rehiyon
- ang mga session ay kailangang manatiling matatag sa pag-paginate
- ang mga trabaho sa koleksyon ay nangangailangan ng diversified na mga ruta ng network
- ang isang uri ng proxy ay gumagana para sa ilang mga domain ngunit hindi sa iba
Hindi nalulutas ng proxies ang bawat isyu sa data pipeline.
Hindi nila maaayos:
- mga poorly written extractors
- mga sira na parsers
- mga invalid schemas
- mga duplicate records
- nawawalang pahintulot o pag-apruba ng patakaran
- mga problema sa browser fingerprint sa kanilang sarili
- mga low-quality labels
- biased na pagpili ng mapagkukunan
Mahalaga ang pagkakaibang ito. Pinapabuti ng proxies ang access at routing, ngunit ang kalidad ng dataset ay nakasalalay pa rin sa validation, cleaning, governance, at disenyo ng mapagkukunan.
Estratehiya sa Routing: Paano Kontrolin ang Gastos at Pagkakatiwalaan
Dapat na nakabatay sa patakaran ang proxy routing.
Sa halip na mag-aplay ng isang pandaigdigang patakaran sa bawat mapagkukunan, tukuyin ang mga patakaran sa routing batay sa domain at workload.
Ang isang malakas na patakaran sa routing ay maaaring isama ang:
- uri ng proxy
- target na GEO
- limitasyon sa concurrency
- tagal ng session
- retry budget
- mga patakaran sa failover
- preference sa browser o HTTP client
- katayuan ng pagsunod
- mga kinakailangan sa validation
Halimbawa ng patakaran:
| Uri ng Domain | Ruta ng Proxy | Patakaran sa Session | Patakaran sa Retry |
|---|---|---|---|
| Pampublikong katalogo | Datacenter | Maikling session | Mag-retry ng dalawang beses na may backoff |
| Localized PDP | Residential ayon sa GEO | Sticky 5–15 minuto | Mag-retry sa parehong rehiyon |
| Login-based source | Residential | Isang session bawat pagkakakilanlan | Walang agresibong retries |
| High-friction source | Residential + browser | Sticky session | Cooldown pagkatapos ng hamon |
| API-approved source | Direct/API | N/A | Igalang ang mga limitasyon ng API |
Ito ay nagpoprotekta sa sistema mula sa labis na paggamit ng mga mamahaling ruta kung saan ang mga mas murang ruta ay gumagana na.
Estratehiya ng Session para sa Training Data Pipelines
Ang pagkolekta ng AI data ay kadalasang nangangailangan ng paulit-ulit na pagbisita sa parehong source sa paglipas ng panahon. Ang disenyo ng session ay nakakaapekto sa parehong rate ng tagumpay at pagkakapare-pareho ng data.
Gumamit ng sticky sessions kapag:
- ang mga pahina ay may pagination
- ang mga filter o estado ng paghahanap ay dapat manatiling pareho
- ang workflow ay sumasaklaw sa maraming hakbang
- ang localized content ay dapat manatiling pare-pareho
- ang cookies ay nakakaapekto sa ibinabalik na data
Gumamit ng rotation kapag:
- ang mga pahina ay independiyente
- ang workload ay stateless
- ang mga source ay naglalagay ng rate-limit ayon sa IP
- ang bawat request ay maaaring ma-validate nang hiwalay
Iwasan ang pag-ikot ng mga IP sa gitna ng multi-step workflow. Maaari itong masira ang continuity ng session at magdulot ng hindi pare-parehong resulta.
Para sa mas malalim na mga pattern ng implementasyon, makakatulong ang SquidProxies proxy tutorials sa mga koponan na ikonekta ang proxy setup sa mga tunay na workflow ng koleksyon.
Geo Accuracy at Dataset Bias
Mahalaga ang geo accuracy kapag nagta-train ng mga modelo sa localized content.
Kung ang iyong pipeline ay naglalayong mangolekta ng mga presyo sa Aleman, ang ruta ng proxy, timezone ng browser, wika, pera, at ibinabalik na content ay dapat lahat tumugma sa target na rehiyon.
I-validate ang geo accuracy gamit ang maraming signal:
- lokasyon ng proxy IP
- wika ng pahina
- pera
- rehiyon ng pagpapadala
- localized banners
- content-language headers
- mga URL na tiyak sa bansa
- availability ng produkto ayon sa rehiyon
Huwag ipagpalagay na ang lokasyon ng IP lamang ang nagpapatunay na tama ang content. Maaaring ibalik ng isang pahina ang isang generic na bersyon, fallback content, o mixed-region results.
Pinipigilan ng geo validation ang nakatagong dataset bias.
Browser Automation sa AI Training Pipelines
Hindi lahat ng AI data pipeline ay nangangailangan ng browser automation. Para sa static HTML o mga source na parang API, mas mabilis at mas mura ang mga lightweight HTTP clients.
Gumamit ng browser automation kapag:
- ang content ay nagre-render sa pamamagitan ng JavaScript
- ang estado ng pahina ay nakakaapekto sa ibinabalik na data
- kinakailangan ang mga interaksyon
- ang content ay lumalabas pagkatapos mag-scroll o mag-filter
- ang mga HTTP client ay nagbabalik ng hindi kumpletong data
- ang pag-uugali ng browser ay nakakaapekto sa localization
Ang mga tool tulad ng Playwright, Puppeteer, at Selenium ay maaaring suportahan ang browser-based collection, ngunit dapat itong gamitin nang may pag-iingat.
Nagpapataas ang mga browser ng gastos sa compute. Gamitin ang mga ito kung saan pinapabuti nila ang wastong output, hindi sa lahat ng dako bilang default.
Pagsunod at Responsableng Pagkolekta ng Data
Kailangan ng mga AI training pipelines ng pamamahala mula sa simula.
Ang isang responsableng proseso ng koleksyon ay dapat:
- igalang ang mga naaangkop na batas at mga tuntunin ng platform
- iwasan ang pag-bypass ng mga access control
- sumunod sa mga kinakailangan sa panloob na pagsusuri
- bawasan ang pagkolekta ng hindi kinakailangang personal na data
- i-filter o alisin ang sensitibong data nang maaga
- panatilihin ang mga audit log sa antas ng source
- idokumento ang layunin ng koleksyon at mga patakaran sa pagpapanatili
- mas gustuhin ang mga opisyal na API, feeds, o pakikipagsosyo kung available
Para sa mas malawak na pagpaplano ng pinapayagang paggamit, i-map ang bawat pipeline sa malinaw na proxy use cases at panatilihin ang isang domain policy registry.
Dapat i-record ng isang domain policy registry ang:
- pangalan ng source
- pinapayagang paraan ng koleksyon
- aprubadong dalas
- mga field ng data na nakolekta
- mga tala ng pagsunod
- proxy route
- mga patakaran sa retention
- may-ari o tagasuri
Pinadadali nito ang pag-audit ng pipeline at mas ligtas itong i-scale.
Ano ang Dapat Sukatin sa Proxy-Aware AI Pipelines
Ang pinakamahalagang metrics ay nag-uugnay ng performance ng infrastructure sa kalidad ng data.
| Metric | Bakit Ito Mahalaga |
|---|---|
| Success rate | Sinusukat ang mga natapos, wastong tugon |
| Block rate | Sinusubaybayan ang friction sa access at mga isyu sa routing |
| Soft block rate | Nahuhuli ang mga pahina na naglo-load ngunit nagbabalik ng hindi magagamit na data |
| CPSR | Ipinapakita ang tunay na gastos bawat matagumpay na resulta |
| Retry depth | Ipinapakita ang nakatagong kawalang-katatagan |
| Geo accuracy | Tinitiyak ang kalidad ng data na partikular sa rehiyon |
| Latency | Nakakaapekto sa throughput at pagiging bago |
| Duplicate rate | Ipinapakita ang mga problema sa koleksyon o normalization |
| Schema pass rate | Sinusukat ang usability sa downstream |
| Dataset freshness | Tinitiyak na ang training data ay kasalukuyan |
Ang CPSR ay nangangahulugang cost per successful request.
Sa simpleng salita: Sinasabi ng CPSR kung magkano ang halaga ng bawat magagamit na record pagkatapos ng gastos sa proxy, compute ng browser, bandwidth, retries, at mga nabigong request.
Maaaring mas mahal ang isang proxy route ngunit mas mababa ang CPSR kung ito ay nagpapababa ng retries at nagpapabuti ng wastong output.
Kontrol sa Gastos: Iwasan ang Sobrang Pagbuo ng Pipeline
Isang karaniwang pagkakamali ang paggamit ng premium infrastructure para sa bawat source.
Sa halip, i-tier ang pipeline:
- Gumamit ng direktang APIs o aprubadong feeds kung available.
- Gumamit ng HTTP clients para sa static o low-friction na mga pahina.
- Gumamit ng datacenter proxies para sa scalable public collection.
- Gumamit ng residential proxies para sa dynamic o geo-sensitive na mga pahina.
- Gumamit ng browser automation lamang kung kinakailangan ang rendering.
- Gumamit ng mas mahigpit na session controls lamang para sa mga high-value workflows.
Ang layered approach na ito ay nagpapanatili ng gastos na naka-align sa hirap.
Real-World Scenario: ECommerce Product Embeddings
Isang AI team ang bumubuo ng product embeddings mula sa mga catalog pages, descriptions, specs, at reviews.
Karamihan sa mga product list pages ay naa-access gamit ang datacenter proxies at simpleng HTTP clients. Ang mga product detail pages ay mas dynamic at minsang nagbabalik ng localized pricing.
Ipinapasa ng team ang mga list pages sa pamamagitan ng datacenter proxies at ipinapadala ang localized product detail pages sa pamamagitan ng residential proxies ayon sa rehiyon. Ang browser rendering ay ginagamit lamang para sa mga pahina kung saan nawawala ang mga mahalagang field mula sa HTML.
Ang resulta ay mas magandang coverage nang hindi inilipat ang buong collection system sa mga mahal na route.
Real-World Scenario: Travel Fare Forecasting
Isang travel data team ang kumokolekta ng fares sa iba't ibang bansa at time windows.
Ang orihinal na pipeline ay nagbabalik ng hindi pare-parehong presyo dahil ang ilang pahina ay naglilingkod ng fallback content kapag ang geo signals ay hindi tumutugma.
Ipinakilala ng team ang residential proxies ayon sa rehiyon, inaayos ang timezone at wika ng browser, pinapatunayan ang currency, at nag-log ng geo markers sa bawat tugon.
Nakakatanggap ang modelo ng mas malinis na regional data, at maihihiwalay ng team ang tunay na pagkakaiba sa merkado mula sa mga artifact ng koleksyon.
Mga Failure Modes na Dapat Bantayan
Hidden Blocks
Ang ilang mga site ay nagbabalik ng status 200 ngunit naglilingkod ng walang laman, generic, o challenge content. I-validate ang content, hindi lamang ang HTTP status.
Retry Storms
Ang walang limitasyong retries ay nagdaragdag ng gastos at maaaring magpalala ng blocking. Gumamit ng backoff at retry limits.
Geo Mismatch
Maaaring ang proxy ay tumuturo sa isang rehiyon habang ang content ay nagpapakita ng iba. I-validate ang mga returned content fields.
Over-Rotation
Ang sobrang pag-ikot ay maaaring makasira sa pagination, cookies, at session continuity.
Duplicate Records
Ang paulit-ulit na retries at URL variations ay maaaring magpataas ng datasets. Gumamit ng stable IDs, canonical URLs, at content hashes.
Source Bias
Ang pagkolekta mula sa mga madaling ma-access na domain lamang ay maaaring magdulot ng bias sa training data. Subaybayan ang pamamahagi at saklaw ng pinagmulan.
Mga Madalas Itanong
Ano ang ibig sabihin ng pagbuo ng AI training pipelines gamit ang proxy infrastructure?
Ibig sabihin nito ay ang paggamit ng managed proxy routing, session controls, at location-aware access bilang bahagi ng data collection layer para sa AI training datasets. Ang layunin ay maaasahan, sumusunod sa regulasyon, at magkakaibang pagkolekta ng data sa isang predictable na halaga.
Kailangan bang laging gumamit ng proxies ang AI training pipelines?
Hindi. Gumamit ng mga opisyal na API, lisensyadong datasets, direktang feeds, o pampublikong downloads kapag available at angkop. Ang mga proxies ay kapaki-pakinabang kapag ang pagkolekta ay nangangailangan ng kontrol sa lokasyon, pamamahagi ng IP, o katatagan ng session.
Aling uri ng proxy ang pinakamahusay para sa AI data collection?
Ang datacenter proxies ay kadalasang pinakamahusay para sa mataas na volume ng mga pampublikong pahina. Ang residential proxies ay mas angkop para sa dynamic, localized, o consumer-facing na nilalaman. Ang tamang proxy ay nakasalalay sa success rate, block rate, geo accuracy, at CPSR.
Paano pinapabuti ng proxies ang kalidad ng AI training data?
Maaari nilang mapabuti ang saklaw, bawasan ang nawawalang data, suportahan ang regional collection, at makatulong na i-refresh ang datasets sa iskedyul. Hindi nila pinapalitan ang validation, cleaning, labeling, o compliance controls.
Paano ko maiiwasan ang pagkolekta ng biased data?
Subaybayan ang saklaw ng pinagmulan, geographic distribution, language coverage, duplicate rate, at freshness. I-validate na ang ibinabalik na nilalaman ay tumutugma sa inaasahang rehiyon o kategorya ng pinagmulan.
Dapat ba akong gumamit ng browser automation para sa AI data collection?
Gumamit ng browser automation lamang kapag ito ay nagpapabuti sa valid output. Kung ang HTTP clients ay nagbabalik ng kumpleto at maaasahang data, kadalasang mas mura at mas mabilis ang mga ito.
Ano ang dapat kong sukatin bago mag-scale?
Sukatin ang success rate, block rate, soft block rate, CPSR, retry depth, geo accuracy, schema pass rate, duplicate rate, at freshness ng dataset.
Paano ko mapapanatiling sumusunod ang pipeline?
Panatilihin ang isang domain policy registry, idokumento ang layunin ng pagkolekta, i-filter ang sensitibong data nang maaga, igalang ang mga naaangkop na batas at termino, at mas mabuting gumamit ng mga aprubadong paraan ng access kapag available.
Huling Kaisipan
Ang AI training pipelines ay kasing maaasahan lamang ng kanilang data collection layer. Ang proxy infrastructure ay tumutulong sa mga koponan na mapabuti ang saklaw, patatagin ang access, kontrolin ang geographic sampling, at bawasan ang nawawalang data kapag ginamit nang responsable.
Ang pinakamalakas na sistema ay hindi umaasa sa random rotation o one-size-fits-all na proxy rules. Gumagamit sila ng policy-driven routing, domain-level controls, session-aware collection, malakas na validation, at malinaw na metrics.
Magsimula sa pinakamurang responsableng ruta na nagbabalik ng valid data. Mag-escalate lamang kapag ang success rate, geo accuracy, o CPSR ay nagpapatunay ng pangangailangan. Para sa mga koponan na nagbabalak ng mas malalaking deployment, suriin ang SquidProxies proxy plans and pricing upang itugma ang proxy infrastructure sa laki ng workload, mga layunin sa kalidad ng data, at operational budget.
Mga Kaugnay na Artikulo
AI Agents at Browser Automation: Mga Kinakailangan sa Inprastruktura
Isang praktikal na gabay sa pagdidisenyo, pag-scale, at pagmamanman ng imprastruktura para sa mga AI agents at browser automation, kasama ang mga decision frameworks, metrics, at mga depensa laban sa mga pagkakamali.
Pagkolekta ng Pampublikong Web Data para sa Pagsasanay ng LLM: Isang Praktikal na Playbook
Isang praktikal at nasusukat na gabay para mangolekta ng pampublikong web data para sa LLM training—saklaw ang arkitektura, proxies, quality controls, metrics, panganib, at isang 30-araw na pilot plan.