 Live Chat
 Mag-log In


AI Agents at Browser Automation: Mga Kinakailangan sa Inprastruktura
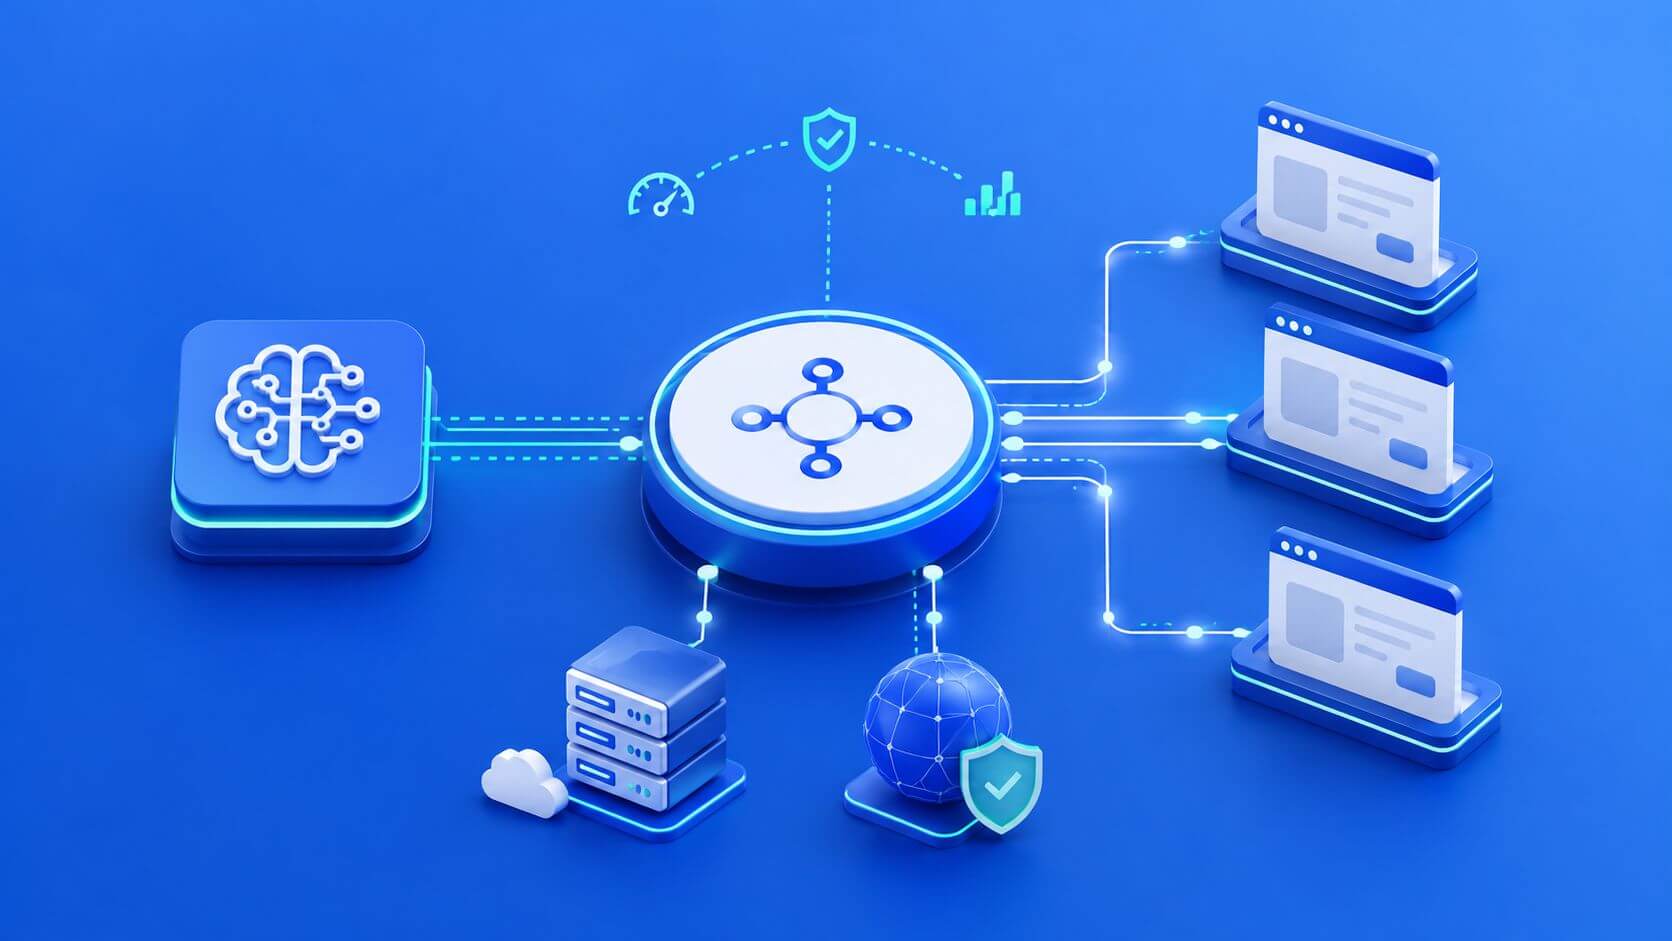
Ang mga AI agent ay kayang magplano ng mga gawain, mag-interpret ng mga pahina, at umangkop sa magulong mga daloy ng trabaho, ngunit umaasa pa rin sila sa maaasahang browser infrastructure. Kung mabibigo ang pag-load ng pahina, mag-reset ang mga session, ma-block ang mga IP, o biglang magbago ang nilalaman ng rehiyon, hindi na mahalaga ang pangangatwiran ng agent—masisira pa rin ang daloy ng trabaho.
Para sa mga team na gumagamit ng web scraping proxies, browser automation, o AI-assisted data collection, ang infrastructure layer ang nagiging tulay upang gawing maaasahang pagpapatupad ang mga desisyon ng agent. Ang isang matibay na setup ay pinagsasama ang browser orchestration, proxy routing, session persistence, observability, compliance controls, at failure recovery.
Ang mga AI agent at browser automation ay nangangailangan ng higit pa sa isang browser driver. Kailangan nila ng production system na dinisenyo para sa pagiging maaasahan, kontrol sa gastos, at kalidad ng data.
Ano ang Kailangan ng AI Agents mula sa Browser Automation Infrastructure
Ang isang AI agent ay kayang magdesisyon kung ano ang i-click, anong pahina ang susuriin, aling field ang kukunin, o paano tutugon kapag nagbago ang isang pahina. Ngunit hindi dapat maging responsable ang agent para sa mga mababang antas ng infrastructure concerns.
Ang isang magandang arkitektura ay naghihiwalay ng mga responsibilidad:
| Layer | Responsibilidad |
|---|---|
| AI agent | Nagpaplano ng mga aksyon, nag-iinterpret ng konteksto, nagdedesisyon ng susunod na hakbang |
| Browser automation layer | Nagpapatupad ng mga click, navigation, forms, waits, at extraction |
| Proxy and network layer | Nag-route ng traffic sa tamang uri ng IP at rehiyon |
| Session layer | Nagpapanatili ng cookies, storage, pagkakakilanlan, at continuity ng daloy ng trabaho |
| Monitoring layer | Nagtatala ng tagumpay, pagkabigo, gastos, latency, at blocks |
| Compliance layer | Nagpapatupad ng mga aprubadong sources, rehiyon, access rules, at audit logs |
Ang paghihiwalay na ito ay nagpapadali sa pag-debug ng sistema. Kung mabibigo ang isang daloy ng trabaho, maaaring matukoy ng mga team kung ang isyu ay nagmula sa agent, sa selector logic, sa browser runtime, sa proxy route, o sa target site.
Mga Pangunahing Komponent ng Infrastructure
Ang isang production-grade AI browser automation stack ay karaniwang naglalaman ng mga sumusunod na komponent.
Browser Runtime
Ang browser runtime ang nagpapatupad ng aktwal na interaksyon sa web. Ang mga karaniwang pagpipilian ay kinabibilangan ng Playwright, Puppeteer, at Selenium.
Gumamit ng browser automation kapag ang daloy ng trabaho ay nangangailangan ng:
- JavaScript rendering
- login o account sessions
- clicks, filters, o form submissions
- dynamic page state
- screenshots o visual confirmation
- multi-step navigation
Para sa mga simpleng static na pahina o APIs, maaaring mas mura at mas mabilis ang HTTP client.
Proxy Layer
Ang proxy layer ang kumokontrol sa network identity, lokasyon, routing, at katatagan ng session.
Gumamit ng datacenter proxies para sa mga public pages na may mababang friction, malawak na monitoring, at mataas na throughput collection kung saan mahalaga ang bilis at gastos.
Gumamit ng residential proxies para sa mga geo-sensitive na pahina, account-based flows, consumer-like browsing, marketplaces, travel, localized pricing, at mas mahigpit na target.
Dapat suportahan ng proxy layer ang:
- routing ayon sa domain
- routing ayon sa bansa o rehiyon
- sticky sessions
- failover
- proxy health checks
- concurrency limits
- cost tracking
Hindi sapat ang isang random proxy list. Kailangan ng mga AI agent ng predictable routing policies upang manatiling matatag ang mga session at pare-pareho ang mga output.
Session at Identity Store
Madalas na nakikipag-ugnayan ang mga AI agent sa multi-step workflows. Ibig sabihin, mahalaga ang mga session.
Dapat panatilihin ng session store ang:
- cookies
- localStorage
- sessionStorage
- account or workflow identifiers
- proxy assignment
- browser profile metadata
- workflow state
- timestamps and expiration rules
Para sa login, cart, quote, dashboard, o search flows, huwag masyadong mag-rotate ng IPs. Panatilihin ang stable na session nang sapat na panahon upang makumpleto ang workflow.
Job Queue at Worker Orchestration
Ang mga AI-driven na browser workflows ay maaaring mabagal, hindi tiyak, at mahal. Ang isang queue-based na sistema ay nagpapadali sa kanilang kontrol.
Ang isang maaasahang job system ay dapat maglaman ng:
- idempotency keys
- priority queues
- per-domain rate limits
- retry budgets
- timeout policies
- failure classification
- worker autoscaling
- dead-letter queues
Ito ay pumipigil sa mga agents na mag-loop nang walang hanggan sa mga sira na pahina o muling subukan ang mga high-friction workflows hanggang sa tumaas ang mga gastos.
Storage at Replay Layer
Mag-imbak ng sapat na artifacts upang ma-debug ang mga pagkakamali nang hindi inuulit ang buong trabaho.
Ang mga kapaki-pakinabang na artifacts ay kinabibilangan ng:
- final HTML
- screenshots
- request logs
- extracted fields
- redirect chains
- error messages
- timestamps
- proxy route metadata
- browser version
- session ID
Para sa mga sensitibo o mataas na halaga na workflows, mag-imbak ng mga replayable snapshots. Ang replay-first debugging ay tumutulong upang paghiwalayin ang mga pansamantalang pagkabigo ng pahina mula sa mga error sa lohika ng agent.
Observability at Metrics
Ang mga AI agents ay maaaring mabigo sa mga banayad na paraan. Ang isang gawain ay maaaring teknikal na makumpleto ngunit magbalik ng maling, hindi kumpleto, o region-mismatched na data.
Ang observability ay dapat subaybayan ang parehong imprastruktura at kalidad ng data.
Mahalagang metrics ay kinabibilangan ng:
- success rate
- block rate
- soft block rate
- retry depth
- session survival
- geo accuracy
- browser crash rate
- P95 latency
- cost per successful request
- extraction validation rate
Ang CPSR ay nangangahulugang cost per successful request.
Sa simpleng salita: sinasabi ng CPSR kung magkano ang halaga ng bawat wastong output pagkatapos ng proxy spend, browser compute, retries, storage, at failures.
Pagpili ng Tamang Browser Mode
Ang browser mode ay nakakaapekto sa gastos, katatagan, at panganib ng detection.
Ang mga headless browsers ay mas mabilis, mas magaan, at mas madaling i-scale. Kadalasan, sila ang tamang default para sa mga pampublikong pahina, monitoring, at mataas na volume ng rendering.
Ang mga headful browsers ay mas mabigat ngunit maaaring mas mahusay para sa mga kumplikado, interaction-heavy, o fingerprint-sensitive na workflows.
Isang praktikal na patakaran:
Magsimula sa headless kung maaari. Mag-escalate sa headful lamang kapag napatunayan ng metrics na ito ay nagpapabuti sa wastong output.
| Workflow | Browser Mode | Bakit |
|---|---|---|
| Static public pages | HTTP client o headless | Mas mababang gastos |
| JavaScript-rendered pages | Headless | Magandang default |
| Login dashboards | Headful o persistent headless | Mas magandang session continuity |
| Marketplace workflows | Headful test group | Mas sensitibo sa mga signal ng browser |
| Geo testing | Headless muna | Mas mabilis na pagbabago ng ruta |
| High-friction targets | Headful fallback | Kapaki-pakinabang para sa mahihirap na flows |
Para sa higit pang detalye, suriin ang gabay sa headless vs headful browsers.
Proxy Strategy para sa AI Agents
Ang mga AI agents ay hindi dapat pumili ng proxies nang basta-basta. Ang proxy routing ay dapat kontrolado ng patakaran.
Ang isang magandang routing policy ay isinasaalang-alang ang:
- domain difficulty
- workflow type
- region requirement
- session length
- proxy cost
- recent block rate
- latency
- success history
Halimbawa ng routing policy:
| Target Type | Proxy Strategy | Session Policy |
|---|---|---|
| Pampublikong pahina | Datacenter proxies | Rotate by batch |
| Localized pages | Residential proxies by GEO | Sticky per region |
| Login flows | Residential proxies | One proxy per session |
| Cart or quote flows | Sticky residential | Keep until workflow completes |
| High-friction pages | Residential + browser profile | Cooldown after challenge |
| Low-value checks | Datacenter | Strict retry limit |
Ang layunin ay gamitin ang pinakamurang ruta na nagbibigay pa rin ng wastong resulta.
Browser Fingerprinting at Session Consistency
Ang browser fingerprinting ay maaaring makaapekto sa pagiging maaasahan ng AI automation. Maaaring suriin ng mga site ang mga signal tulad ng User-Agent, WebGL, fonts, timezone, wika, sukat ng screen, bersyon ng browser, at WebRTC behavior.
Kung ang mga signal na ito ay hindi tugma sa proxy route, ang session ay maaaring makaranas ng higit pang friction.
Halimbawa:
- lokasyon ng proxy: Pransya
- timezone ng browser: Estados Unidos
- wika: Ingles lamang
- User-Agent: Windows
- fonts: Linux-like
- WebRTC: nag-leak ng ibang network path
Ang inconsistency na iyon ay maaaring magpababa ng tiwala.
Ang isang matatag na browser profile ay dapat tumugma sa:
- rehiyon ng proxy
- timezone
- wika
- User-Agent
- viewport
- cookies
- storage
- WebRTC behavior
- layunin ng session
Para sa mas malalim na paliwanag, basahin ang browser fingerprinting for web scraping at WebRTC leaks.
Paano Dapat Hawakan ng AI Agents ang Mga Pagkabigo
Kailangan ng AI agents ng mga guardrails. Kung wala ang mga ito, maaari silang mag-retry nang masyado, maling basahin ang mga sirang pahina, o magpatuloy pagkatapos ng isang nabigong estado.
Bawat workflow ay dapat mag-uri ng mga pagkabigo.
Mga karaniwang uri ng pagkabigo:
- navigation timeout
- selector missing
- login failed
- CAPTCHA o challenge page
- blocked response
- soft block
- geo mismatch
- browser crash
- proxy timeout
- invalid extracted data
Bawat uri ng pagkabigo ay nangangailangan ng ibang tugon.
| Uri ng Pagkabigo | Mas Mabuting Tugon |
|---|---|
| Timeout | Retry once with backoff |
| Missing selector | Capture screenshot and flag parser review |
| Blocked response | Reduce concurrency or change route |
| Geo mismatch | Switch proxy region and validate again |
| CAPTCHA prompt | Pause, reduce load, or use approved access path |
| Browser crash | Restart worker and preserve artifacts |
| Invalid data | Do not mark job successful |
Iwasan ang pagtrato sa bawat pagkabigo bilang isang problema sa proxy. Maraming pagkabigo ang nagmumula sa mga pagbabago sa pahina, estado ng browser, desisyon ng agent, o maling mga palagay.
CAPTCHA at Paghawak ng Mga Hamon
Para sa compliance-first automation, ang layunin ay bawasan ang mga hindi kinakailangang trigger ng hamon, hindi talunin ang mga sistema ng CAPTCHA.
Dapat tumugon ang mga AI agents sa mga paulit-ulit na CAPTCHA prompts sa pamamagitan ng:
- pagbawas ng concurrency
- pag-back off
- pag-reschedule ng trabaho
- pag-check ng consistency ng browser fingerprint
- paglipat sa isang aprubadong API o feed kung available
- pag-flag ng source para sa pagsusuri ng patakaran
Para sa mga gabay na nakatuon sa pag-iwas, gamitin ang artikulo sa CAPTCHA avoidance techniques.
Huwag hayaang patuloy na mag-retry ang isang AI agent sa mga challenge pages. Sayang ang budget at nagdaragdag ng operational risk.
Architecture Pattern: Hybrid Browser Fleet
Ang hybrid browser fleet ay kadalasang pinaka-cost-effective na setup.
Gamitin:
- HTTP clients para sa simpleng mga pahina
- headless browsers para sa JavaScript rendering
- headful browsers para sa mahihirap na workflows
- datacenter proxies para sa low-friction na mga target
- residential proxies para sa sensitibo o geo-specific na mga target
- sticky sessions para sa multi-step na mga daloy
Isang pinadaling arkitektura:
AI Agent
   ↓
Task Planner
   ↓
Job Queue
   ↓
Browser Worker
   ↓
Proxy Router
   ↓
Target Website
   ↓
Validation Layer
   ↓
Storage + Observability
Ang router ang nagdedesisyon kung ang isang gawain ay dapat gumamit ng HTTP, headless, headful, datacenter, o residential batay sa polisiya at mga kamakailang metrics.
Ano ang Dapat Sukatin Bago Mag-Scale
Huwag mag-scale ng AI agent browser workflow hangga't hindi matatag ang mga metrics.
Subaybayan:
| Metric | Bakit Ito Mahalaga |
|---|---|
| Success rate | Ipinapakita ang mga natapos na wastong gawain |
| Soft block rate | Nahuhuli ang maling o hindi kumpletong resulta |
| Block rate | Sinusubaybayan ang access friction |
| Retry depth | Ipinapakita ang nasayang na trabaho |
| Session survival | Sinusukat ang katatagan ng workflow |
| Geo accuracy | Kumpirmado ang localized content |
| Browser crash rate | Ipinapakita ang pagiging maaasahan ng imprastruktura |
| P95 latency | Pinoprotektahan ang mga inaasahang delivery |
| CPSR | Ipinapakita ang tunay na gastos sa yunit |
| Validation pass rate | Kumpirmado ang kalidad ng nakuhang data |
Hindi sapat ang mga average. Subaybayan ang mga metrics batay sa domain, uri ng proxy, mode ng browser, rehiyon, at workflow.
Kontrol sa Gastos para sa AI Browser Automation
Maaari maging mahal ang mga AI agent kung ang bawat gawain ay dumadaan sa pinakamalakas na imprastruktura.
Kontrolin ang gastos sa pamamagitan ng pag-tier ng stack:
- Gumamit ng APIs o feeds kung available.
- Gumamit ng HTTP clients para sa static na mga pahina.
- Gumamit ng headless browsers para sa JavaScript na mga pahina.
- Gumamit ng datacenter proxies para sa tolerant na mga target.
- Gumamit ng residential proxies para sa sensitibo o rehiyonal na mga target.
- Gumamit ng headful browsers lamang kung ang mga metrics ay nagpapakita ng pangangailangan.
- Limitahan ang retries at haba ng session ng browser.
- I-imbak ang mga artifacts lamang kung makakatulong ito sa debugging o compliance.
Ang ganitong diskarte ay nagpapanatili ng scalable na pipeline nang hindi nagbabayad ng sobra para sa mga simpleng pahina.
Real-World Scenario: ECommerce Price Intelligence
Isang AI agent ang nagmamasid sa presyo ng produkto sa iba't ibang retailer at rehiyon.
Ang unang bersyon ay gumagamit ng isang configuration ng browser para sa bawat domain. Mabilis na tumataas ang gastos, at may ilang retailer na nagbabalik ng nawawalang presyo.
Ang pinabuting bersyon ay naghahati-hati ng workflow:
- ang mga pampublikong pahina ng kategorya ay gumagamit ng headless browsers at datacenter proxies
- ang localized na mga pahina ng produkto ay gumagamit ng residential proxies batay sa rehiyon
- ang mahihirap na cart-based na mga daloy ay gumagamit ng sticky residential sessions
- ang mga nabigong pahina ay naverify gamit ang screenshots bago ang retries
Ang resulta ay mas mababang retry depth, mas mahusay na regional accuracy, at mas predictable na CPSR.
Real-World Scenario: Travel Fare Monitoring
Isang travel team ang gumagamit ng AI agents para mangolekta ng availability ng fare at mga detalye ng polisiya.
Ang ilang mga pahina ay nangangailangan ng JavaScript rendering, habang ang iba ay nagbabalik ng structured HTML. Ang ilang mga bansa ay nagpapakita ng iba't ibang presyo depende sa rehiyon.
Ang team ay bumuo ng mga routing rules:
- ang mga madaling pahina ay gumagamit ng HTTP clients
- ang mga dynamic na pahina ay gumagamit ng Playwright
- ang mga rehiyon-sensitive na pahina ay gumagamit ng residential proxies
- ang mga high-friction na ruta ay pinabagal at sinusubaybayan nang hiwalay
Pinapanatili nito ang sistema na maaasahan nang hindi inililipat ang bawat ruta sa mamahaling browser sessions.
Governance at Compliance Controls
Mabilis na makakagawa ng aksyon ang mga AI agents, kaya ang governance ay dapat na nakabuo sa imprastruktura.
Gumamit ng:
- mga aprubadong listahan ng domain
- source policy registry
- per-domain rate limits
- audit logs
- region controls
- credential vaults
- mga patakaran sa pag-iimbak ng data
- mga workflow para sa pagsusuri ng pagkabigo
- tao na pag-apruba para sa sensitibong mga gawain
Dapat gumana ang mga agents sa loob ng malinaw na mga hangganan. Hindi sila dapat magdesisyon nang mag-isa na ma-access ang mga restricted na lugar, lumampas sa mga kontrol, o palawakin ang saklaw ng koleksyon.
Para sa mas malawak na pagpaplano, i-align ang mga workflow sa mga nakadokumentong proxy use cases.
Implementation Checklist
Bago ilunsad, tiyakin:
- Ang bawat domain ay may routing policy.
- Ang uri ng proxy ay tumutugma sa hirap ng workload.
- Ang browser mode ay pinili batay sa data, hindi sa preference.
- Ang sessions ay nagpapatuloy para sa multi-step flows.
- Ang cookies at storage ay hiwalay batay sa workflow.
- Ang concurrency ay nakatakda sa bawat domain.
- Ang retry depth ay limitado.
- Ang failure artifacts ay nahuhuli.
- Ang geo accuracy ay napatunayan.
- Ang CPSR ay sinusubaybayan ayon sa ruta.
- Ang compliance rules ay nakadokumento.
14-Day Pilot Plan
Days 1–3: Baseline
Magpatakbo ng maliit na set ng mga representative tasks. Sukatin ang success rate, block rate, retry depth, latency, at CPSR.
Days 4–7: Routing Tests
Ihambing ang datacenter vs residential proxies at headless vs headful browser modes sa mga mahihirap na domain.
Days 8–10: Session Tests
Magdagdag ng sticky sessions para sa multi-step flows. Subaybayan ang session survival at validation pass rate.
Days 11–14: Reliability Controls
Magdagdag ng circuit breakers, backoff, failure screenshots, queue limits, at domain-level dashboards.
I-scale lamang ang mga configuration na nagpapabuti sa valid output at cost.
Frequently Asked Questions
Anong infrastructure ang kailangan ng AI agents para sa browser automation?
Kailangan nila ng browser runtime, proxy routing, session storage, job queues, observability, validation, at compliance controls. Ang browser ang nagsasagawa ng mga tasks, habang ang infrastructure ay nagpapanatili ng stability at measurability ng sessions.
Dapat bang gumamit ang AI agents ng headless o headful browsers?
Magsimula sa headless para sa bilis at cost. Gumamit ng headful lamang kapag ang workflow ay login-heavy, fingerprint-sensitive, o paulit-ulit na hindi stable sa headless mode.
Aling uri ng proxy ang pinaka-angkop para sa AI browser automation?
Ang datacenter proxies ay mahusay para sa mga lower-friction public pages. Ang residential proxies ay mas mabuti para sa geo-sensitive, account-based, o consumer-like workflows.
Paano dapat pamahalaan ang sessions?
Panatilihin ang cookies, local storage, proxy assignment, at device profile para sa habang-buhay ng isang workflow. Iwasan ang pag-ikot ng IPs sa gitna ng session para sa login, cart, quote, o dashboard flows.
Paano ko mapipigilan ang mga agents na mag-loop sa mga sirang pahina?
Gumamit ng step limits, timeouts, DOM assertions, failure classification, retry caps, at dead-letter queues. I-store ang mga screenshots at HTML para sa debugging.
Ano ang dapat kong sukatin?
Subaybayan ang success rate, block rate, soft block rate, retry depth, session survival, geo accuracy, P95 latency, browser crash rate, validation pass rate, at CPSR.
Kailangan ba ng AI agents ng residential proxies?
Hindi palaging. Gumamit ng residential proxies kapag mahalaga ang rehiyon, session trust, o consumer-like network signals. Gumamit ng datacenter proxies para sa mas simpleng, high-volume public pages.
Paano ko mapapanatiling kontrolado ang mga gastos?
I-route ayon sa hirap. Gumamit ng HTTP clients at datacenter proxies kung saan posible, pagkatapos ay umakyat sa browsers, residential proxies, o headful sessions lamang kapag ang metrics ay nagpapakita ng halaga.
Final Thoughts
Ginagawa ng AI agents na mas flexible ang browser automation, ngunit pinapataas din nito ang pangangailangan para sa disiplinadong infrastructure. Ang agent ay dapat tumuon sa pagpaplano at pangangatwiran. Ang platform ay dapat humawak ng routing, session stability, observability, validation, at compliance.
Ang pinakamalakas na sistema ay hybrid: magaan kung saan simple ang mga pahina, makatotohanan kung saan sensitibo ang workflows, at measurable sa lahat ng dako.
Para sa suporta sa implementasyon, tuklasin ang SquidProxies proxy tutorials at proxy plans and pricing upang i-match ang mga pagpipilian sa infrastructure sa laki ng workload, antas ng panganib, at operating budget.
Mga Kaugnay na Artikulo
Pagkolekta ng Pampublikong Web Data para sa Pagsasanay ng LLM: Isang Praktikal na Playbook
Isang praktikal at nasusukat na gabay para mangolekta ng pampublikong web data para sa LLM training—saklaw ang arkitektura, proxies, quality controls, metrics, panganib, at isang 30-araw na pilot plan.
Pagbuo ng AI Training Pipelines gamit ang Proxy Infrastructure
Isang praktikal na gabay sa pagdidisenyo ng AI training pipelines gamit ang proxy infrastructure: arkitektura, pagpili ng proxy, mga estratehiya sa routing, mga sukatan, mga tradeoff sa gastos, at mga mode ng pagkabigo. Kasama ang mga decision frameworks, mga real-world na senaryo, at FAQs para sa parehong teknikal at business teams.