 Live Chat
 Mag-log In


Naka-tag: web scraping16 mga artikulo
Paano Nakikita ng mga Retailer ang Competitive Price Scraping
Isang praktikal na gabay kung paano natutukoy ng mga retailer ang price scraping, ang mga senyales at bitag na ginagamit nila, at kung paano makakapagdisenyo ang mga data, SEO, at pricing teams ng matibay at nasusukat na scraping operations nang hindi lumalampas sa mga gastos o block rates.
Gabay sa Inprastruktura ng Pagsubaybay sa Presyo ng E-Commerce
Isang praktikal at metrics-driven na gabay sa pagdidisenyo, pagpapatakbo, at pag-scale ng e-commerce price monitoring infrastructure para sa mga marketing, SEO, at data teams.
Pagbuo ng AI Training Pipelines gamit ang Proxy Infrastructure
Isang praktikal na gabay sa pagdidisenyo ng AI training pipelines gamit ang proxy infrastructure: arkitektura, pagpili ng proxy, mga estratehiya sa routing, mga sukatan, mga tradeoff sa gastos, at mga mode ng pagkabigo. Kasama ang mga decision frameworks, mga real-world na senaryo, at FAQs para sa parehong teknikal at business teams.
Mga Teknik sa Pag-iwas sa CAPTCHA para sa Browser Automation
Mga praktikal at compliance-first na estratehiya para mabawasan ang CAPTCHA friction sa browser automation. Alamin kung paano magdisenyo ng mga session, hubugin ang traffic, pumili ng proxies, at subaybayan ang tamang metrics para mapataas ang success rate at mabawasan ang gastos sa bawat matagumpay na request.
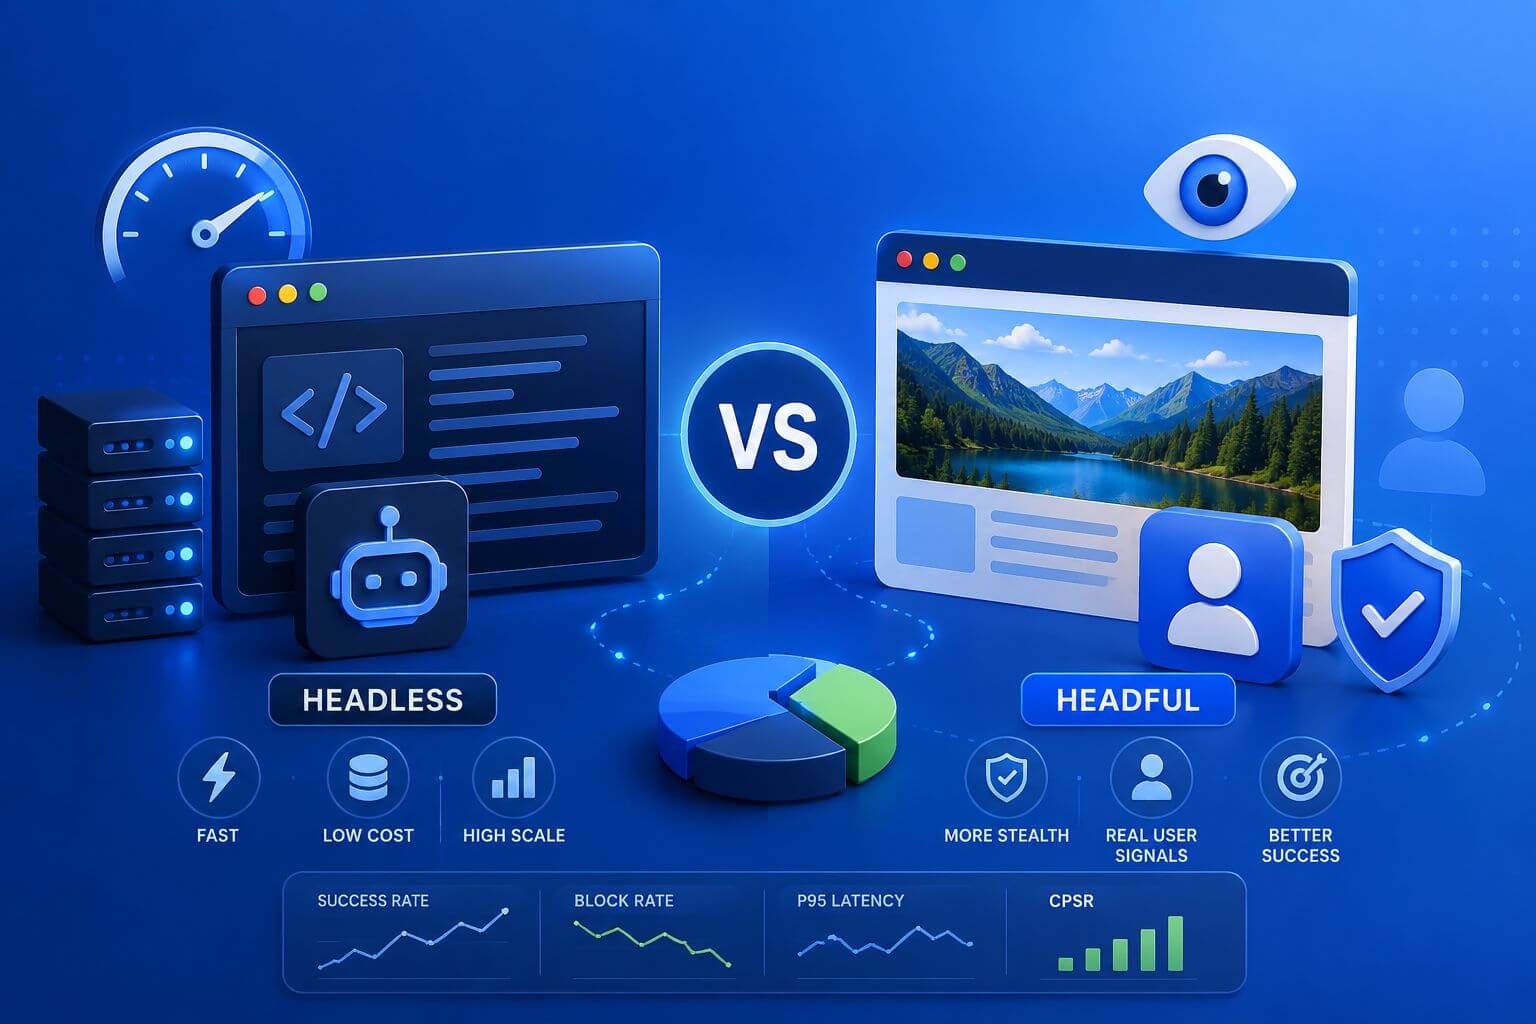
Headless vs Headful Browsers sa Modernong Scraping: Paano Pumili
Isang praktikal at metrics-driven na gabay sa pagpili sa pagitan ng headless at headful browsers para sa modernong web scraping, kasama ang mga decision frameworks, real-world scenarios, tuning tips, at kung ano ang dapat sukatin.
Browser Fingerprinting para sa Web Scraping: Ano ang Maaaring Ayusin at Hindi Maaaring Ayusin ng Proxies
Isang praktikal na gabay sa browser fingerprinting sa web scraping at ang mga tiyak na problema na kayang lutasin at hindi kayang lutasin ng proxies. Kasama ang mga framework ng desisyon, mga failure modes, mga metrics na dapat subaybayan, at mga totoong senaryo para sa mga team na nag-run ng scraping, automation, at data collection sa malaking sukat.
Browser Fingerprinting: Paliwanag para sa mga Scraper
Alamin kung paano naaapektuhan ng browser fingerprinting ang modernong web scraping at kung bakit hindi sapat ang proxies lamang para sa matatag na automation. Ang gabay na ito ay naglalarawan ng mga signal ng browser tulad ng user agent, WebRTC, canvas, timezone, at session behavior, kasama ang mga praktikal na estratehiya para mabawasan ang CAPTCHA, soft blocks, geo mismatches, at hindi matatag na browser sessions sa malaking sukat.
Pinakamahusay na Proxy Setup para sa Playwright Automation
Alamin kung paano bumuo ng pinakamahusay na proxy setup para sa Playwright automation gamit ang residential at datacenter proxies, sticky sessions, browser contexts, at smart rotation strategies. Ang praktikal na gabay na ito ay nagpapaliwanag kung paano bawasan ang block rates, pagbutihin ang session stability, i-optimize ang concurrency, at pababain ang CPSR para sa malakihang browser automation at web scraping workflows.
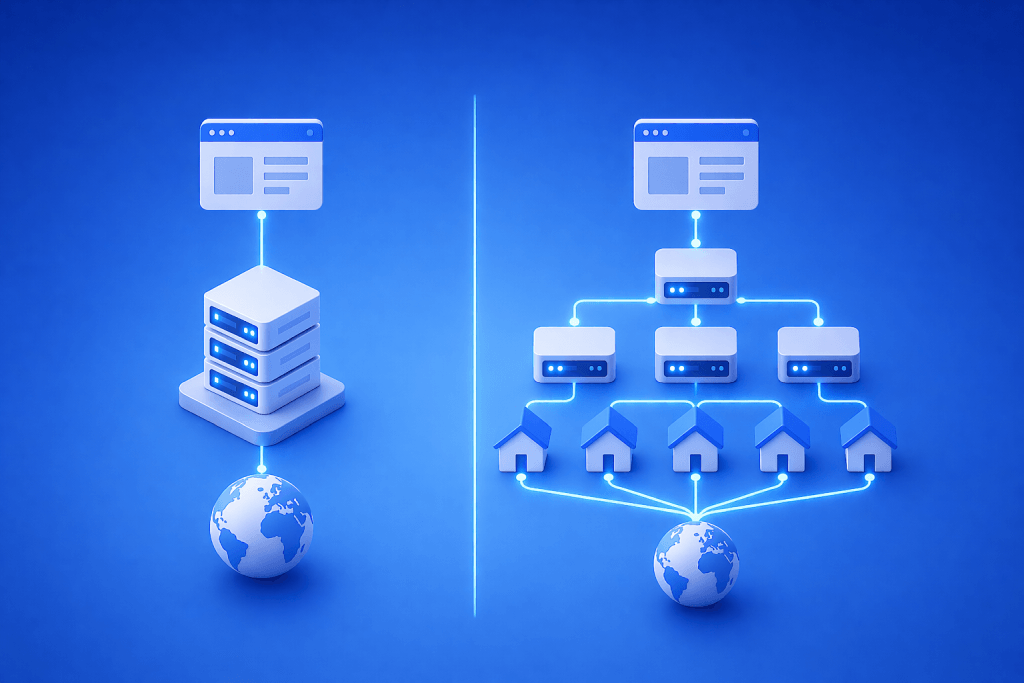
Stabilidad ng Scraper: Mga Pagkakaiba ng Dev at Production Proxy
Bakit pumapasa ang mga scrapers sa dev pero bumabagsak sa production, paano nagbabago ang proxies sa scale, at paano magdisenyo ng mga stable na ruta, rotations, at metrics na nagpapababa ng failure at cost.
Pag-iwas sa mga Bottleneck sa Pagkolekta ng Data gamit ang Proxies
Isang praktikal na gabay para alisin ang mga pagkaantala sa data collection sa pamamagitan ng pagtutugma ng mga uri ng proxy sa mga workload, pag-tune ng rotation at concurrency, at pagmamanman sa block rate at CPSR. Ginawa para sa SEO, eCom, travel, finance, at mga data team.
Data Collection at Scale: Infrastructure Best Practices
Isang praktikal na gabay sa pagdidisenyo, pagpapatakbo, at pagpapabuti ng mga sistema ng koleksyon ng data sa malaking sukat. Alamin ang tungkol sa network design, scraping architecture, quality controls, compliance, at cost levers para sa maaasahang pipelines.
ASN Diversity: Bakit Mahalaga Ito sa Proxy Infrastructure
Isang praktikal at production-focused na gabay sa ASN diversity sa proxy infrastructure: ano ito, bakit ito nakakapagpababa ng blocks, paano planuhin ang iyong ASN mix, at paano ito i-validate at i-monitor sa tunay na scraping at automation workloads.
Proxy Pool Architecture para sa Mataas na Dami ng Pagkolekta ng Data
Isang praktikal at production-grade na gabay sa pagdidisenyo, pag-scale, at pagmamanman ng proxy pool architecture para sa mataas na volume ng web data collection na may malinaw na KPIs, rotation strategies, at decision frameworks.

Mga Estratehiya sa Proxy Rotation: Paano Bawasan ang Blocks Nang Hindi Nasira ang Sessions
Isang praktikal at production-grade na gabay sa mga estratehiya ng proxy rotation na nagbabawas ng blocks, nagpapanatili ng session state, at nagpapalawak ng data collection. Saklaw nito ang mga rotation policies, uri ng proxy, decision frameworks, monitoring signals, pitfalls, at FAQs para sa mga operator at engineer.
403, 429, at CAPTCHA Errors: Paano I-diagnose ang Proxy Blocks
Isang praktikal at production-grade na gabay sa pag-diagnose at pag-aayos ng 403, 429, at CAPTCHA errors sa web scraping at automation. Alamin kung paano tukuyin ang mga ugat na sanhi, pumili ng tamang proxy mix, mag-set ng speed limits, at i-instrument ang iyong stack para mapanatiling kontrolado ang block rates.
Ang Mga Benepisyo ng Rotating Proxies
Alamin kung paano pinapabuti ng rotating proxies ang pagiging maaasahan, scalability, geo-targeting, at ban resistance para sa ethical data collection, SEO, at verification workflows.