 Live Chat
 Mag-log In


Pagkolekta ng Pampublikong Web Data para sa Pagsasanay ng LLM: Isang Praktikal na Playbook
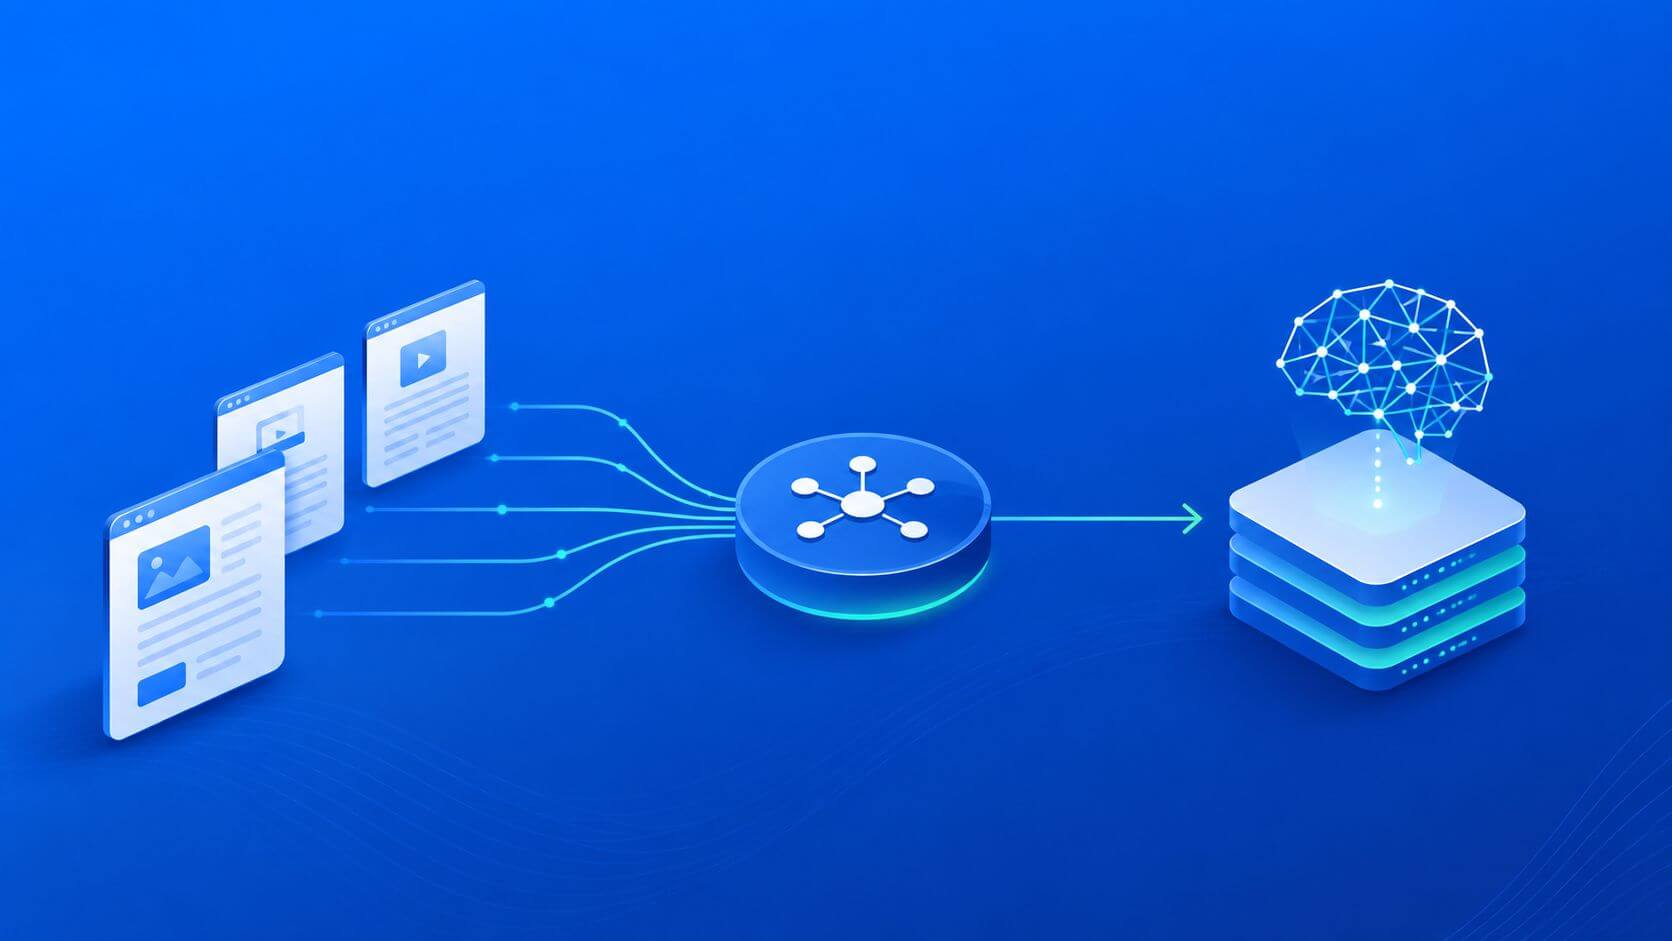
Ang mga malalaking modelo ng wika ay kasing kapaki-pakinabang lamang ng datos na nasa likod nito. Kung ang source data ay lipas na, duplicated, may regional bias, hindi maayos ang lisensya, o puno ng mababang kalidad na mga pahina, ang modelo ay magrereflekt ng mga kahinaang iyon. Ang resulta ay madalas na mas masamang sagot, mas maraming hallucinations, mas mataas na gastos sa pagsusuri, at mas mahina na performance sa tunay na mga workflow ng produkto.
Ang pagkolekta ng pampublikong web data para sa LLM training ay hindi lamang isang problema ng scraping. Ito ay isang problema ng data governance, imprastruktura, pagsunod, at quality control. Kailangan ng mga team ng isang pipeline na makakatuklas ng mga pinapayagang source, mangolekta ng nilalaman nang responsable, i-validate ang ibinalik na data, panatilihin ang metadata, alisin ang hindi ligtas o hindi kinakailangang impormasyon, at i-route ang mahihirap na workload sa tamang imprastruktura.
Para sa mga team na kumokolekta ng pampublikong web data sa malaking sukat, ang data for AI workflows ay madalas na nangangailangan ng kombinasyon ng source planning, crawl control, proxy routing, data validation, at patuloy na monitoring. Ang layunin ay hindi lamang mangolekta ng mas maraming teksto. Ang layunin ay bumuo ng isang malinis, traceable, at defensible dataset na nagpapabuti sa performance ng modelo nang hindi lumilikha ng hindi kinakailangang legal, operational, o reputational risk.
Ano ang Ibig Sabihin ng Pagkolekta ng Pampublikong Web Data para sa LLM Training
Ang pagkolekta ng pampublikong web data para sa LLM training ay nangangahulugang pagtuklas, pagkuha, pagproseso, at pag-iimbak ng bukas na accessible na nilalaman na maaaring gamitin para sa training ng modelo, fine-tuning, pagsusuri, retrieval, o enrichment.
Ang isang responsableng pipeline ay dapat sumagot sa mga tanong na ito bago magsimula ang koleksyon:
- Ang source ba ay pampublikong accessible nang walang login, paywall, o circumvention?
- Ang mga tuntunin ng site, robots directives, o kondisyon ng lisensya ba ay tugma sa nakatakdang gamit?
- Anong mga data fields ang kinakailangan?
- Anong data ang dapat alisin?
- Paano aalisin ang mga duplicates, boilerplate, at hindi ligtas na nilalaman?
- Paano mapapanatili ang source metadata at provenance?
- Paano susukatin ang kalidad ng koleksyon?
Mahalaga ito dahil ang LLM training data ay hindi lamang hinuhusgahan batay sa dami. Ito ay hinuhusgahan batay sa kapaki-pakinabang, coverage, freshness, rights, at traceability.
Ano ang Itinuturing na Pampublikong Web Data?
Ang pampublikong web data ay karaniwang tumutukoy sa nilalaman na accessible nang walang authentication, bayad, o teknikal na circumvention. Ang mga halimbawa ay maaaring kabilang ang pampublikong dokumentasyon, impormasyon mula sa gobyerno, mga pahina ng open-source na proyekto, pampublikong katalogo ng produkto, blogs, RSS feeds, pampublikong sitemaps, at open-licensed datasets.
Gayunpaman, ang "pampublikong nakikita" ay hindi awtomatikong nangangahulugang "libre gamitin para sa training ng modelo." Ang mga koleksyon na team ay kailangan pa ring suriin:
- mga tuntunin ng site
- mga tagubilin sa robots.txt
- katayuan ng copyright o lisensya
- mga obligasyon sa privacy
- sensitivity ng data
- mga kinakailangan na partikular sa hurisdiksyon
- mga patakaran sa internal compliance
Kung ang mga karapatan ay hindi malinaw, ang mas ligtas na landas ay ang alisin ang source, humiling ng pahintulot, gumamit ng opisyal na API, o maghanap ng licensed data feed.
Bakit Mahalaga ang Kalidad ng Pampublikong Web Data para sa LLMs
Ang mababang kalidad na training data ay maaaring lumikha ng magastos na mga problema sa downstream.
Ang masamang inputs ay maaaring magdulot ng:
- hallucinated o lipas na mga sagot
- biased na pag-uugali ng modelo
- mahirap na regional understanding
- hindi kaugnay na mga resulta ng retrieval
- paulit-ulit na boilerplate na mga sagot
- duplicated na mga halimbawa ng training
- hindi ligtas o toxic na outputs
- mahina na performance sa mga niche na domain
Ang mataas na kalidad na pampublikong web data ay nagpapabuti sa:
- factual coverage
- consistency ng sagot
- vocabulary na partikular sa domain
- multilingual o regional representation
- kalidad ng pagsusuri
- kaugnayan ng retrieval
- kahusayan ng fine-tuning
Para sa mga business teams, ang mas magandang data ay maaaring magpababa ng gastos sa pagsusuri at magpabuti ng mga resulta ng produkto. Para sa mga engineering teams, ang mas malinis na data ay nagpapababa ng rework sa pipeline, oras ng debugging, at pag-aaksaya sa retraining.
Magsimula sa Source Strategy, Hindi sa Crawling
Ang isang malakas na LLM data pipeline ay nagsisimula sa pagpili ng source.
Bago kumuha ng kahit ano, tukuyin:
- ang use case ng modelo
- mga target na wika
- mga target na rehiyon
- mga kategorya ng domain
- mga katanggap-tanggap na uri ng pinagmulan
- mga uri ng pinagmulan na hindi kasama
- mga kinakailangan sa karapatan
- dalas ng pag-update
- mga pamantayan sa kalidad
Halimbawa, maaaring kailanganin ng isang support assistant ang opisyal na dokumentasyon, mga pahina ng help center, at mga tala ng paglulunsad ng produkto. Maaaring kailanganin ng isang market intelligence model ang mga pampublikong katalogo ng produkto, mga pahina ng presyo, mga pampublikong pagsusuri kung pinapayagan, at nilalaman ng rehiyon. Maaaring kailanganin ng isang multilingual assistant ang maingat na balanseng saklaw ng wika.
Kung walang estratehiya sa pinagmulan, maaaring mag-over-collect ang pipeline ng mga madaling pahina habang nawawala ang mahahalagang rehiyon, format, o domain.
Mga Daan ng Koleksyon: Alin ang Dapat Mong Gamitin?
Iba't ibang mga pamamaraan ng koleksyon ang may iba't ibang gastos, panganib, at mga profile ng kalidad.
| Daan ng Koleksyon | Pinakamainam Para sa | Profile ng Gastos at Panganib |
|---|---|---|
| Open-licensed datasets | Baseline corpora, pampublikong reference data | Mas mababang panganib kung malinaw ang lisensya |
| Official APIs | Structured data, maaasahang access | Predictable at mas madaling pamahalaan |
| RSS o Atom feeds | Balita, mga update, sariwang nilalaman | Epektibo para sa pagtuklas ng pagbabago |
| Sitemaps | Blogs, docs, catalogs | Magandang para sa structured discovery |
| Static HTML fetching | Pampublikong pahina na may server-rendered content | Mababang gastos at scalable |
| Browser rendering | JavaScript-heavy na mga pahina | Mas mataas na gastos; gamitin nang may pag-iingat |
| Licensed partner feeds | Mataas na halaga ng paulit-ulit na data | Gastos ng kontrata, mas malakas na kalinawan sa karapatan |
Ang pinakamainam na tuntunin ay simple: gamitin ang pinaka-maaasahan, permission-friendly, at cost-efficient na pamamaraan ng koleksyon na available. Gamitin ang browser rendering at kumplikadong imprastruktura lamang kapag hindi maibigay ng mas simpleng mga pamamaraan ang kumpleto, wastong data.
Saan Pumapasok ang Proxy Infrastructure
Nakakatulong ang proxy infrastructure kapag ang layer ng koleksyon ay nangangailangan ng kontroladong network routing, geographic coverage, o distributed access patterns. Maaari itong suportahan ang pampublikong koleksyon ng data sa pamamagitan ng pagpapabuti ng pagiging maaasahan sa iba't ibang rehiyon, pagbawas ng sobrang konsentrasyon mula sa isang ruta, at pagtulong sa mga koponan na i-validate ang localized content.
Para sa mga simpleng pampublikong pahina, maaaring sapat na ang datacenter proxies. Karaniwan silang mabilis, predictable, at cost-efficient para sa malakihang koleksyon mula sa mga mababang hadlang na pinagmulan.
Para sa geo-sensitive, consumer-facing, o region-specific na mga pahina, maaaring mas angkop ang residential proxies. Maaari silang makatulong sa mga koponan na kumpirmahin kung anong nilalaman ang ipinapakita mula sa mga tiyak na bansa o lungsod.
Para sa mas malawak na pagpaplano ng implementasyon, dapat tratuhin ang web scraping proxies bilang bahagi ng layer ng koleksyon ng data—hindi bilang kapalit para sa pagsunod, validation ng pinagmulan, o paglilinis ng data.
Isang Praktikal na Arkitektura ng Pipeline
Karaniwang kasama sa isang scalable na pampublikong web data pipeline ang mga sumusunod na bahagi:
-
Source registry
Nagtatago ng mga aprubadong domain, uri ng pinagmulan, mga patakaran sa koleksyon, mga tala ng lisensya, at mga may-ari. -
Discovery layer
Gumagamit ng sitemaps, feeds, APIs, seed URLs, at mga aprubadong listahan ng domain upang makahanap ng mga candidate pages. -
Fetcher layer
Gumagamit ng HTTP clients o browser automation depende sa kumplikado ng pinagmulan. -
Routing layer
Pumipili ng direktang access, datacenter proxies, residential proxies, o mga region-specific na ruta batay sa patakaran. -
Parser layer
Nag-eextract ng text, headings, links, tables, metadata, at structured fields. -
Normalization layer
Nililinis ang HTML, inaalis ang boilerplate, nadidetect ang wika, pinapantay ang encoding, at hinahati ang text. -
Deduplication layer Tinatanggal ang eksaktong at halos magkaparehong nilalaman gamit ang URL normalization, hashes, at similarity checks.
-
Safety and compliance filters Tinatanggal o minamarkahan ang personal na data, hindi ligtas na nilalaman, mga pinaghihigpitang mapagkukunan, at materyal na may panganib sa lisensya.
-
Storage and lineage Nagsasagawa ng pag-save ng raw fetches, nilinis na teksto, metadata, hashes, bersyon ng parser, timestamps, at mga tala ng karapatan.
-
Training-ready export Gumagawa ng versioned datasets para sa fine-tuning, evaluation, RAG indexing, o enrichment.
Ang pinadaling daloy ay mukhang ganito:
Approved Sources
   ↓
Discovery
   ↓
Fetcher / Browser Worker
   ↓
Proxy and Routing Policy
   ↓
Parser
   ↓
Normalization
   ↓
Deduplication
   ↓
Safety and Rights Filters
   ↓
Versioned Dataset
   ↓
LLM Training / RAG / Evaluation
Bawat yugto ay dapat na observable. Kung ang output ng modelo ay nagiging questionable, dapat kayang subaybayan ng team kung aling source, bersyon, parser, at filter ang nag-produce ng training example.
Proxy Selection for LLM Data Workloads
Dapat nakadepende ang pagpili ng proxy sa uri ng source at sensitivity ng data.
| Workload | Recommended Route | Why |
|---|---|---|
| ------------------------- | ----------------------------------------- | --------------------------------------- |
| Public documentation | Direct or datacenter | Mababang friction, predictable structure |
| Blogs and public articles | Datacenter | Epektibo para sa malakihang pag-fetch |
| Regional public content | Residential by GEO | Tumutulong sa pag-validate ng localized pages |
| Product catalogs | Datacenter first, residential fallback | Kontrolado ang gastos habang pinapabuti ang coverage |
| JavaScript-heavy pages | Browser rendering with controlled routing | Gamitin lamang kapag incomplete ang static HTML |
| Public feeds and APIs | Direct/API access | Kadalasang pinaka-maaasahan at compliant |
Huwag gumamit ng premium proxy routes sa lahat ng pagkakataon. Gumamit ng pinakamababang gastos na responsable na ruta na nagbabalik ng kumpleto, wasto, at aprubadong nilalaman.
Browser Rendering: Use It Selectively
Maaari maging kapaki-pakinabang ang browser automation kapag ang nilalaman ay na-render sa pamamagitan ng JavaScript o nakatago sa likod ng client-side interactions. Gayunpaman, mas mahal ang mga browser kumpara sa HTTP clients.
Gumamit ng browser rendering kapag:
- walang laman o incomplete ang static HTML
- mahalagang teksto ay naglo-load pagkatapos ng JavaScript execution
- ang istruktura ng pahina ay nakadepende sa interaksyon
- ang nilalaman ay lumalabas pagkatapos ng filters o pagination
- kinakailangan ang isang rendered snapshot para sa validation
Iwasan ang browser rendering kapag:
- may opisyal na API
- nagbibigay ng sapat na nilalaman ang RSS o sitemaps
- naglalaman ng kinakailangang teksto ang static HTML
- hindi pinapabuti ng gastos ng browser ang kalidad ng data
Ang mga tool tulad ng Playwright, Puppeteer, at Selenium ay maaaring suportahan ang rendering workflows, ngunit dapat lamang itong i-route sa mga pahina na nagjustify ng karagdagang gastos.
Data Quality Controls for LLM Training
Dapat tanggihan ng public web data pipeline ang masamang nilalaman nang maaga.
Mahalagang quality checks ay kinabibilangan ng:
- detection ng wika
- mga limitasyon sa haba ng nilalaman
- pagtanggal ng boilerplate
- detection ng duplicate
- detection ng near-duplicate
- extraction ng page title
- preservation ng heading hierarchy
- extraction ng pangunahing nilalaman
- detection ng sira na encoding
- mga filter para sa hindi ligtas na nilalaman
- detection at pagtanggal ng PII
- tagging ng lisensya o karapatan
- pagsusuri ng reputasyon ng source
Para sa paggamit ng LLM, mahalaga ang konteksto. Itago ang mga pamagat, mga URL ng pahina, mga petsa ng publikasyon, at estruktura ng seksyon kung saan posible. Ang isang talata na walang konteksto ng pinagmulan ay maaaring hindi kasing kapaki-pakinabang ng parehong talata na may kasamang pamagat, heading, wika, petsa, at metadata ng pinagmulan.
Metadata na Dapat Mong Itago
Sa pinakamababa, itago ang:
- URL
- canonical URL
- source domain
- crawl timestamp
- content hash
- wika
- rehiyon o GEO
- uri ng pinagmulan
- lisensya o rights tag
- parser version
- extraction method
- HTTP status
- redirect chain
- robots o policy status
- dedupe status
- safety filter status
Mahalaga ang metadata na ito para sa auditing, debugging, deduplication, retraining, takedowns, at evaluation.
Metrics na Nagtutukoy na Gumagana ang Pipeline
Subaybayan ang metrics sa buong source, domain, ruta, wika, at rehiyon.
| Metric | Bakit Ito Mahalaga |
|---|---|
| Success rate | Ipinapakita kung gaano kadalas nakokolekta ang mga wastong pahina |
| Block rate | Ipinapakita ang access o routing friction |
| CPSR | Sinusukat ang gastos bawat matagumpay na request |
| Dedupe rate | Ipinapakita kung gaano karaming duplicate na nilalaman ang natanggal |
| Schema pass rate | Kumpirmahin ang downstream usability |
| Freshness lag | Sinusubaybayan kung gaano kasariwa ang dataset |
| Language coverage | Pinipigilan ang labis na representasyon ng isang wika |
| Geo accuracy | Kumpirmahin na ang nilalaman ng rehiyon ay wasto |
| Rejection rate | Ipinapakita kung gaano karaming nilalaman ang nabigo sa mga quality o safety checks |
| Source diversity | Binabawasan ang labis na pag-asa sa madaling mga pinagmulan |
Ang CPSR ay nangangahulugang gastos bawat matagumpay na request. Sa simpleng salita, sinasabi nito sa iyo kung magkano ang halaga ng bawat magagamit na pahina pagkatapos isama ang mga gastos sa imprastruktura, proxy, browser, retry, at mga pagkabigo.
Pagsunod at Pamamahala
Ang koleksyon ng pampublikong web data para sa pagsasanay ng LLM ay dapat pamahalaan mula sa simula.
Ang isang responsableng proseso ay dapat:
- igalang ang mga naaangkop na batas
- sundin ang mga tuntunin ng site at mga direktiba ng robots kung naaangkop
- iwasan ang mga login walls, paywalls, o pag-iwas sa access-control
- mas gusto ang mga API at lisensyadong feeds kung available
- bawasan ang koleksyon ng personal na data
- i-filter ang mga sensitibong field nang maaga
- itago ang provenance
- suportahan ang mga proseso ng takedown at opt-out
- idokumento ang layunin ng koleksyon
- panatilihin ang pagmamay-ari ng reviewer para sa bawat kategorya ng pinagmulan
Ang isang domain policy registry ay lalong kapaki-pakinabang. Dapat nitong tukuyin kung ano ang maaaring kolektahin, gaano kadalas, sa pamamagitan ng aling ruta, sa ilalim ng aling lisensya o policy note, at para sa anong layunin.
Para sa mas malawak na pagpaplano, i-map ang mga aprubadong workflow sa malinaw na proxy use cases upang manatiling konektado ang mga desisyon sa imprastruktura sa mga kinakailangan ng negosyo at pagsunod.
Karaniwang Mga Paraan ng Pagkabigo
Masyadong Malawak na Koleksyon
Hindi laging mas mabuti ang mas maraming data. Ang hindi na-filter na koleksyon ay maaaring magdala ng ingay, duplication, at legal na kawalang-katiyakan.
Pagwawalang-bahala sa Rights Metadata
Kung hindi mo ma-trace ang status ng lisensya o mga pahintulot ng pinagmulan, nagiging mas mahirap ipagtanggol at muling gamitin ang dataset.
Pagsasanay sa Duplicate na Nilalaman
Ang mga duplicated na pahina ay maaaring magpabigat sa ilang mga parirala, brand, format, o opinyon.
Nawawalang Regional Signals
Kung ang mga regional na pahina ay nakolekta mula sa maling lokasyon, maaaring matutunan ng modelo ang maling impormasyon sa presyo, availability, o patakaran.
Parser Drift
Ang mga redesign ng site ay maaaring tahimik na masira ang extraction. Subaybayan ang null rates, mga pagbabago sa haba ng nilalaman, at mga pagkabigo sa schema.
Train/Test Contamination
Kung ang evaluation data ay nag-overlap sa training data, maaaring mukhang mas maganda ang performance ng modelo kaysa sa tunay na kalagayan nito.
30-Araw na Pilot Plan
Gumamit ng isang kontroladong pilot bago mag-scale.
Linggo 1: Pagsusuri ng Saklaw at Pinagmulan
Pumili ng 5–10 na aprubadong domain. Tukuyin ang mga target na wika, kategorya ng pinagmulan, mga field, exclusions, at rights notes.
Linggo 2: Koleksyon at Pagsubok sa Routing
Gumawa ng limitadong crawl gamit ang pinakamababang gastos sa responsableng ruta. Magdagdag ng proxies lamang kung kinakailangan ang lokasyon, pagiging maaasahan ng access, o kontroladong distribusyon.
Linggo 3: Pagsasala ng Kalidad at Kaligtasan
Mag-apply ng deduplication, mga pagsusuri sa wika, pagtanggal ng boilerplate, PII filtering, at pag-tag ng lisensya. Suriin ang isang sample nang manu-mano.
Linggo 4: Pagsusuri ng Dataset
I-export ang isang maliit na training o retrieval dataset. Sukatin ang pagpapabuti laban sa isang baseline gamit ang mga product-specific evaluation tasks.
Subaybayan:
- rate ng tagumpay
- rate ng block
- CPSR
- rate ng dedupe
- rate ng pagtanggi
- schema pass rate
- freshness lag
- evaluation lift
Palakihin lamang ang mga mapagkukunan at routing policies na nagdadala ng nasusukat na halaga.
Real-World Scenario: Product Knowledge Assistant
Nais ng isang kumpanya na pagbutihin ang isang product support assistant.
Kolektahin ng team ang opisyal na dokumentasyon ng produkto, mga pampublikong FAQ, mga tala ng release, at mga pahina ng help center. Sinasaklaw ng mga sitemaps at APIs ang karamihan sa mga mapagkukunan. Ang ilang mga pahina ay nangangailangan ng rendering dahil ang nilalaman ay naglo-load nang dinamiko.
Pinapanatili ng pipeline ang mga pamagat ng pahina, mga heading ng seksyon, mga petsa ng pag-update, mga URL ng mapagkukunan, at mga tag ng lisensya. Ang deduplication ay nag-aalis ng mga paulit-ulit na nabigasyon at boilerplate.
Nagmimithi ang assistant dahil ang dataset ay nakatuon, kasalukuyan, nasusubaybayan, at naka-align sa domain ng produkto.
Real-World Scenario: Regional Market Intelligence
Nagtatayo ang isang team ng LLM-powered research assistant para sa pagsusuri ng rehiyonal na merkado.
Kailangan ng sistema ang mga pampublikong pahina ng presyo, availability ng tindahan, mga paglalarawan ng produkto, at mga pahina ng patakaran na tiyak sa bansa. Gumagamit ang team ng region-specific routing para sa mga pahina na nagbabago ayon sa lokasyon at pinapatunayan ang currency, wika, at rehiyon ng pagpapadala bago itago ang nilalaman.
Pinipigilan nito ang modelo na matutunan ang generic o maling impormasyon sa rehiyon.
Mga Madalas Itanong
Ano ang pagkolekta ng pampublikong web data para sa LLM training?
Ito ay ang proseso ng pagkuha ng pinapayagang pampublikong nilalaman, responsableng pagkolekta nito, paglilinis, paglalagay ng metadata, at paghahanda nito para sa model training, evaluation, retrieval, o enrichment.
Laging ligtas bang gamitin ang pampublikong web data para sa LLM training?
Hindi. Ang pampublikong visibility ay hindi awtomatikong nagbibigay ng mga karapatan sa training. Dapat suriin ng mga team ang mga termino, status ng lisensya, mga direktiba ng robots, mga patakaran sa privacy, at mga kinakailangan sa internal compliance.
Kailangan ko ba ng proxies para sa LLM data collection?
Hindi palagi. Gumamit ng mga opisyal na APIs, feeds, open datasets, at direktang access kung saan ito ay gumagana. Ang proxies ay kapaki-pakinabang kapag ang koleksyon ay nangangailangan ng geographic control, distributed routing, o mas mahusay na pagiging maaasahan sa mga pampublikong mapagkukunan.
Alin ang pinakamahusay na uri ng proxy para sa pagkolekta ng pampublikong web data?
Ang mga datacenter proxies ay karaniwang epektibo para sa pampublikong static na nilalaman. Ang mga residential proxies ay mas mahusay para sa geo-sensitive o consumer-facing na mga pahina kung saan ang lokasyon ay nakakaapekto sa ibinabalik na nilalaman.
Dapat ba akong gumamit ng browser automation?
Tanging kapag kinakailangan. Ang browser automation ay kapaki-pakinabang para sa mga JavaScript-heavy na pahina ngunit nagdadala ng gastos at kumplikado. Gumamit muna ng mga HTTP clients, APIs, feeds, at sitemaps.
Anong metadata ang dapat kong itago?
Itago ang URL, canonical URL, crawl time, wika, rehiyon, uri ng mapagkukunan, tag ng lisensya, content hash, parser version, extraction method, at safety-filter status.
Paano ko mababawasan ang duplicate na data?
Gumamit ng canonical URLs, normalized URLs, content hashes, near-duplicate detection, at source-level deduplication bago i-export ang training shards.
Paano ko malalaman kung ang data ay nagpapabuti sa modelo?
Magsagawa ng controlled evaluation. Ihambing ang baseline performance laban sa bagong dataset gamit ang mga product-specific tasks tulad ng accuracy ng sagot, groundedness, helpfulness, quality ng retrieval, o nabawasang escalation rate.
Pangwakas na Kaisipan
Ang pagkolekta ng pampublikong web data para sa LLM training ay dapat ituring na isang disiplinadong data pipeline, hindi isang bulk crawling exercise. Ang pinakamahusay na mga sistema ay nagsisimula sa source strategy, rights review, at mga kinakailangan sa kalidad bago magsimula ang anumang malawakang koleksyon.
Gumamit ng mga opisyal na mapagkukunan at open-licensed na datasets kung posible. Magdagdag ng sitemaps, feeds, at magalang na crawling para punan ang mga puwang. Gumamit ng proxy infrastructure lamang kung ito ay nagpapabuti sa coverage, reliability, o geo accuracy. Panatilihin ang metadata, alisin ang hindi ligtas o hindi kinakailangang nilalaman, at sukatin ang pipeline batay sa magagamit na output—hindi sa raw page count.
Para sa mga team na nagbabalak ng mas malalaking AI data operations, ang SquidProxies proxy tutorials at proxy plans and pricing ay makakatulong upang i-align ang routing strategy, scale, at cost sa mga pangangailangan ng iyong data pipeline.
Mga Kaugnay na Artikulo
AI Agents at Browser Automation: Mga Kinakailangan sa Inprastruktura
Isang praktikal na gabay sa pagdidisenyo, pag-scale, at pagmamanman ng imprastruktura para sa mga AI agents at browser automation, kasama ang mga decision frameworks, metrics, at mga depensa laban sa mga pagkakamali.
Pagbuo ng AI Training Pipelines gamit ang Proxy Infrastructure
Isang praktikal na gabay sa pagdidisenyo ng AI training pipelines gamit ang proxy infrastructure: arkitektura, pagpili ng proxy, mga estratehiya sa routing, mga sukatan, mga tradeoff sa gastos, at mga mode ng pagkabigo. Kasama ang mga decision frameworks, mga real-world na senaryo, at FAQs para sa parehong teknikal at business teams.