 Live Chat
 Mag-log In


Proxies para sa AI Data Collection: Tradeoffs ng Stability at Scale
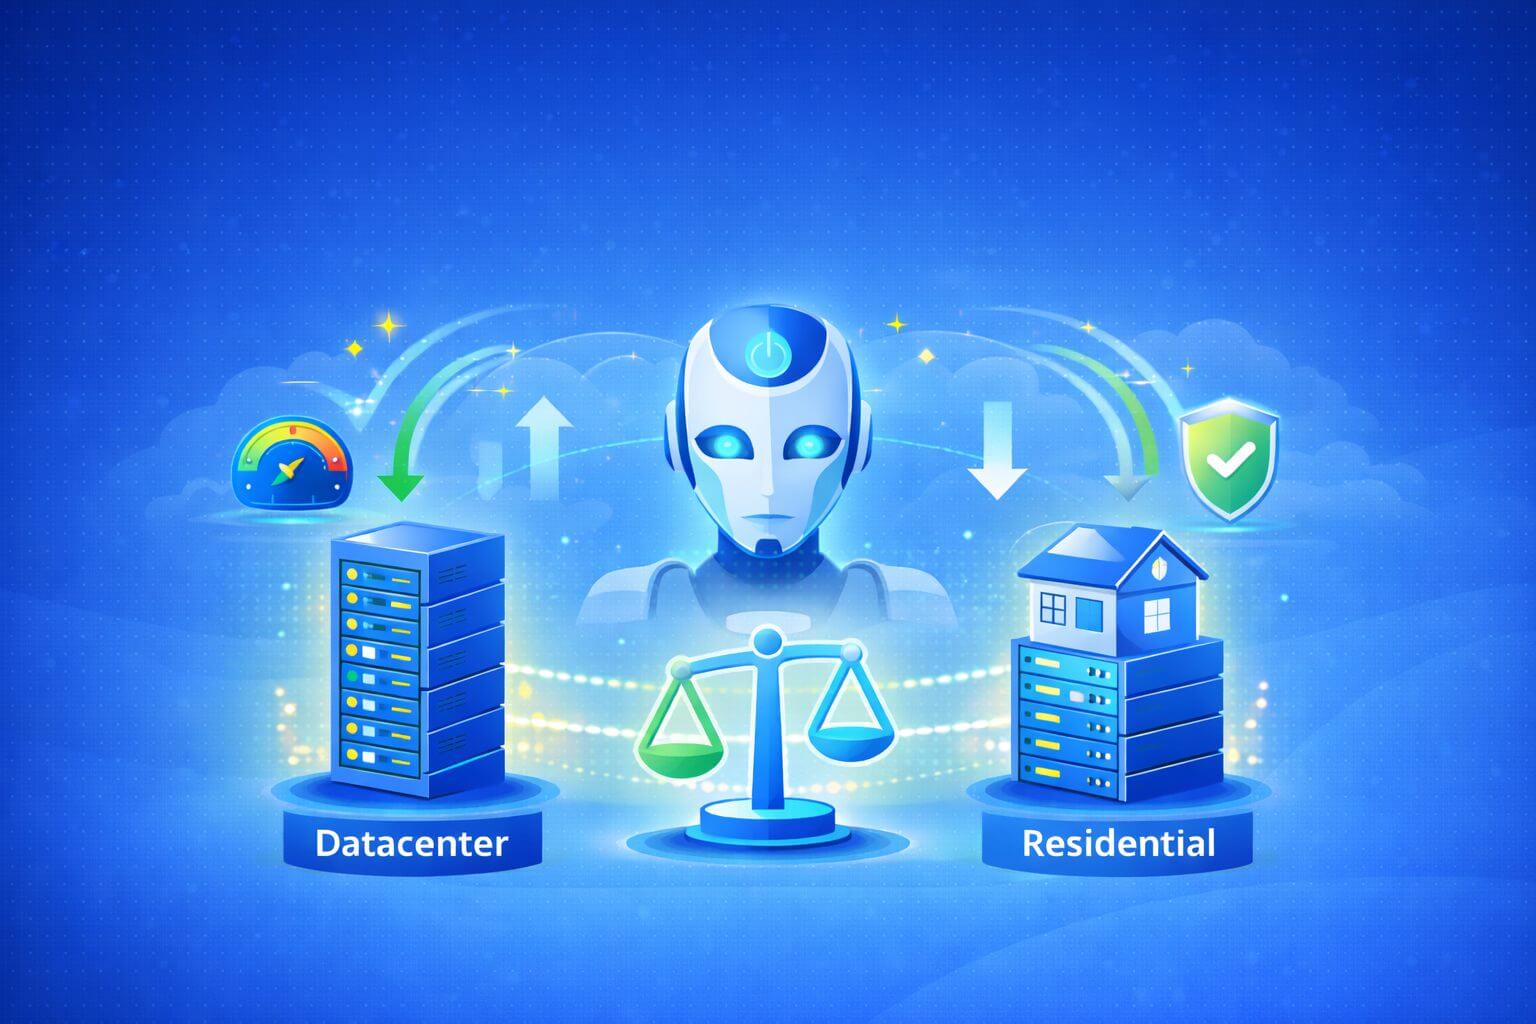
Ang iyong training data feed ay nagiging mabagal sa ilalim ng biglaang demand, o mas masahol pa, nahaharang sa kalagitnaan ng isang mataas na stake na crawl. Ang ugat na sanhi ay kadalasang pareho: pagpili o pagpapatakbo ng maling proxies para sa AI data collection. Itong gabay ay nagpapakita kung paano balansehin ang stability at scale, pumili ng tamang proxy mix, at bumuo ng pipeline na makakaligtas sa tunay na anti-bot pressure. Ano ang makukuha mo: isang field-tested framework para magdesisyon, mag-implement, at mag-validate ng iyong proxy strategy.
Ang mga proxies ay nagbibigay-daan sa mga AI data collectors na ma-access ang geo-specific content, ipamahagi ang load, at bawasan ang mga block. Ang tradeoff ay simple: mas maraming scale ay kadalasang nagbabawas ng session stability, habang ang sobrang pokus sa stability ay maaaring magpabagal sa throughput. Ang pinakamahusay na diskarte ay gumagamit ng mga angkop na uri ng proxy, maingat na concurrency, at feedback loops.
Bakit mahalaga ang stability vs scale para sa mga data teams
Kung ikaw ay nagpapatakbo ng mga modelo o dashboards na nagbabago araw-araw, ang mga puwang sa collection ay nagiging sanhi ng data drift. Nakakasira ito sa accuracy ng modelo at time-to-insight. Sa kabilang banda, ang sobrang pag-scale ng proxies ay maaaring magpataas ng block rates at magpataas ng retries, na nag-aaksaya ng mga margin.
Mula sa pananaw ng imprastruktura, ang stability ay nangangahulugang ang mga session ay tumatagal ng sapat na panahon upang makumpleto ang mga gawain na may mababang block rates. Ang scale ay nangangahulugang pagpapanatili ng mataas na request volume na may katanggap-tanggap na gastos sa bawat matagumpay na tugon. Ang pag-optimize sa parehong ito ay isang patuloy na tuning problem, hindi isang one-time na pagpili.
Ang stability–scale curve sa praktika
- Kung itutulak mo ang concurrency masyadong mabilis, maaari mong i-trigger ang WAFs, captchas, o soft bans.
- Kung masyadong madalas ang pag-ikot ng IPs, mawawalan ka ng session state o shopping carts.
- Kung masyadong mahaba ang mga session, maaari kang magmukhang kahina-hinala o makalikom ng cookies na nag-fingerprint sa iyong bot.
Mag-isip sa mga curve, hindi mga puntos. Magsimula ng maliit, sukatin ang block rate at success rate sa ilalim ng iba't ibang concurrency at rotation windows, pagkatapos ay lumipat pakanan sa curve hanggang makita mo ang pressure. Umurong ng kaunti at itakda ang autoscale guards doon.
Kailan gagamit ng datacenter pools para sa AI collection bursts
Ang mga datacenter IPs ay mabilis, predictable, at cost-efficient. Maganda ang mga ito para sa static assets, price pages na walang mabigat na bot defenses, public docs, at mga API-like endpoints na tumatanggap ng malawak na cloud ranges.
- Pinakamainam para sa high-throughput pulls kung saan mahalaga ang latency at gastos.
- I-pair ito sa mahigpit na concurrency caps bawat domain at adaptive backoff.
- Asahan ang mas mahigpit na rate limits sa login flows at checkout paths.
Para sa mas malalim na pagtingin sa mga pattern at constraints, tingnan ang mabilis na datacenter proxies.
Kailan makatuwiran ang residential networks
Ang mga residential IPs ay dumadaan sa mga consumer devices at lokal na ISPs. Mas maganda ang pagsasama nito sa karaniwang traffic ng user at kadalasang nagbabawas ng blocks sa mas mahihirap na target.
- Pinakamainam para sa dynamic pages, mabigat na JavaScript, at mga flow sa likod ng anti-bot checks.
- Kapaki-pakinabang para sa geo accuracy sa ad verification, lokal na imbentaryo, o localized SERPs.
- Asahan ang mas mataas na gastos sa bawat request; offset ito sa mas mababang block at retry rates.
Kung ang iyong mga target ay naglalabas ng captchas o device checks, isaalang-alang ang pagsisimula gamit ang residential proxies upang mapabuti ang tagumpay sa bawat pagtatangka.
Ang mga use cases ang nagmamaneho ng pagpili, hindi kabaligtaran
I-map ang iyong mga target ayon sa sensitivity at kinakailangang session behavior, pagkatapos ay pumili ng proxy ayon dito. Karaniwang mga bucket:
- Low-friction: public listings, static content, FAQ o policy pages.
- Medium-friction: eCommerce category pages, travel search, basic filters.
- High-friction: cart, checkout, account areas, classifieds na may login.
Maraming halimbawa at pattern ang saklaw sa mga common proxy use cases.
Mga architecture patterns na nagbabalanse ng stability at scale
Ang isang resilient proxy pipeline ay nagsisimula sa simple at nagdadagdag ng complexity lamang kapag ito ay bumibili ng reliability o throughput.
- Pamamahala ng session
- Gumamit ng sticky sessions para sa mga flow na umaasa sa cookies, carts, o pagination.
- Para sa one-shot GETs, ang maiikli na sessions na may rotation ay nagbabawas ng correlation.
- I-pin ang per-host session rules sa code, hindi sa global settings.
- Pag-ikot at pag-backoff
- Mag-rotate sa mga signal: 429/403 spikes, captcha events, at tumataas na TTFB.
- Magdagdag ng jitter sa parehong rotation windows at retry delays.
- Panatilihin ang per-domain queues na may kani-kanilang QPS ceilings.
- Kontrol ng concurrency
- I-tune ang concurrent connections per ASN/ISP para maiwasan ang hot spots.
- Gumamit ng token buckets per target domain.
- I-scale ang workers kapag ang success rate ay nananatiling matatag sa loob ng N minuto.
- Mga pagpipilian sa transport
- Magsimula sa HTTP clients para sa static o semi-static na mga pahina.
- Gumamit ng headless browsers lamang kapag kinakailangan (JS rendering, WebGL checks).
- I-cache ang HTML fragments at assets para mabawasan ang redundant requests.
- Kalusugan at failover
- Panatilihin ang maliit na standby pool ng pangalawang uri ng proxy para sa instant failover.
- I-automate ang ramp-down sa block spikes at ramp-up sa recovery.
- I-log ang mga natatanging error fingerprints, hindi lamang ang status codes.
Mga sukatan na mahalaga (at kung paano ito gamitin)
Subaybayan ang mga signal na ito per domain at per proxy type:
- Block rate: porsyento ng mga request na nagbabalik ng 403/429 o captcha walls.
- Success rate: 2xx o validated HTML selectors na natagpuan.
- Session stability: average na pahina bawat session nang walang pinipilit na pag-ikot.
- Geo accuracy: bahagi ng mga request na nagreresolba sa nakatakdang rehiyon.
- Latency: oras hanggang sa unang byte (TTFB) at buong load para sa rendered flows.
- Cost per successful response (CPSR): kabuuang proxy + compute cost / matagumpay na responses.
Formula: CPSR = (proxy_cost + compute_cost + captcha_cost) / successful_responses. Sa simpleng salita: kung magkano ang binabayaran mo para sa bawat kapaki-pakinabang na pahina na iyong nakolekta.
Mga halimbawa ng target na dapat i-validate sa isang pilot:
- Block rate na mas mababa sa 5–10% sa low-friction targets.
- Session stability ng 3–6 na pahina sa pag-crawl ng pag-paginate na kategorya.
- Geo accuracy na higit sa 95% para sa ad checks.
Dalawang maiikling senaryo mula sa field
Senaryo 1: Retail price tracking sa scale
- Nagsimula sa datacenter IPs, mataas ang tagumpay sa mababang volume ngunit bumagsak sa peak hours.
- Ang paglipat ng category pages sa datacenter na may mas mahigpit na per-domain QPS, at product detail pages sa residential para sa stability, ay nagbawas ng retries ng kalahati.
- Net result: mas magandang CPSR kahit na tumaas ang gastos sa proxy unit.
Senaryo 2: Travel search na may dynamic JS
- Ang paunang headless + residential ay gumana, ngunit tumaas ang gastos.
- Ang pre-rendering ng search form at pag-cache ng static bundles ay nagbigay-daan sa team na makapagbigay ng mas marami gamit ang HTTP clients.
- Ang datacenter IPs ay humawak ng static assets; ang residential ay nanatili lamang sa booking flow.
Mag-ingat sa mga ito
- Pagsusulong ng concurrency batay sa bilang ng mga worker, hindi sa target tolerance.
- Pag-rotate ng IPs sa isang nakatakdang iskedyul sa halip na tumugon sa mga signal.
- Sobrang paggamit ng headless browsers kapag ang text-only clients ay sapat na.
- Pagwawalang-bahala sa ASN/ISP diversity; masyadong maraming IPs mula sa isang provider ay nag-trigger ng blocks.
- Pagtreat sa captchas bilang mga pagkabigo sa halip na signal para baguhin ang taktika.
- Paghahayaan ang cookie jars na lumaki nang walang pruning, na nagdudulot ng pagdududa.
Mga pattern ng scraping at anti-bot pressure
Ang mga anti-bot systems ay naghahanap ng volume surges, magkaparehong headers, at predictable paths. Mahalaga ang maliliit na pagbabago.
- I-stagger ang mga request at magdagdag ng randomness sa pagkakasunod-sunod ng nabigasyon.
- Mag-rotate ng user-agents sa loob ng makatotohanang pamilya na konektado sa OS at device.
- I-reuse ang sessions lamang kung ito ay nakakatulong; kung hindi, paboran ang maiikli ang buhay na sessions.
- Pumili ng server-side rendering kapag ang mga target ay nag-e-expose ng HTML snapshots.
Para sa mas malawak na overview ng mga pattern, tingnan ang mga web scraping use cases and practices.
Proxies para sa AI data collection: stability-first choices
Magsimula sa pinakamadaling setup na tumutugon sa iyong quality bar. Magdagdag ng scale kapag ang mga sukatan ay nananatiling matatag.
- Kung ang target ay pampubliko at tolerant, subukan ang datacenter muna na may mahigpit na QPS.
- Kung makikita mo ang maagang spikes ng 403/429 o captchas, ilipat ang mga key flows sa residential.
- Panatilihin ang parehong opsyon na handa. Ang tamang sagot ay maaaring magbago batay sa domain at linggo.
Ang tamang proxies para sa AI data collection ay ang mga nagmumungkahi ng mababang CPSR habang natutugunan ang freshness SLAs at compliance rules. Anumang iba pa ay isang optimization problem na walang layunin sa negosyo.
Checklist ng Implementasyon
- Tukuyin ang mga layunin per domain: rate ng tagumpay, rate ng block, pagiging bago.
- Pumili ng unang uri ng proxy batay sa kinakailangang friction at geo.
- Mag-set ng konserbatibong concurrency at rotation na may jitter.
- Mangolekta ng structured logs ng blocks, captchas, at retries.
- Magpatakbo ng 7–10 araw na pilot, baguhin lamang ang isang factor sa isang pagkakataon.
- I-lock ang mga guardrails at alerto sa paglihis ng metric.
Mga Madalas na Itanong
Q1: Paano ko malalaman kung datacenter o residential ang dapat piliin para sa bagong target?
- Magsimula sa isang maikling probe. Kung mataas ang 2xx success sa katamtamang QPS at walang lumalabas na captchas, maaaring okay ang datacenter. Kung makatagpo ka ng 403/429 o dynamic checks nang maaga, lumipat sa residential para sa mga kritikal na hakbang at subukan muli.
Q2: Ano ang magandang rotation policy para sa session stability?
- Mag-rotate batay sa signals, hindi sa timer. Gumamit ng sticky sessions para sa carts o pagination, at mag-rotate sa block spikes o captchas. Magdagdag ng random jitter upang maiwasan ang synchronized patterns sa mga workers.
Q3: Paano ko susukatin ang ROI bukod sa success rate?
- Gumamit ng CPSR at time-to-freshness. Kung mas mahal ang residential pero pinapababa ang retries at human solves, maaari itong mapabuti ang CPSR. I-tie ang metrics sa revenue drivers tulad ng price accuracy o ad verification coverage.
Q4: Kailangan ko ba ng headless browsers para sa AI data collection?
- Kailangan lamang kapag ang target ay umaasa sa mabigat na JavaScript o device checks. Subukan muna ang HTTP clients. Kung kinakailangan ang headless, i-cache ang mga assets at i-pre-warm ang sessions upang mapanatiling mababa ang gastos at latencies.
Q5: Ano ang mga karaniwang sanhi ng biglaang block spikes?
- Mga jumps sa concurrency, reused fingerprints, o sobrang daming requests mula sa parehong ASN. Suriin ang mga kamakailang deploys, bawasan ang QPS, mag-rotate ng IP pools, at i-refresh ang headers o TLS fingerprints kung kinakailangan.
Q6: Paano ko dapat hawakan ang captchas?
- Ituring ang mga ito bilang routing signal. Bawasan ang QPS, lumipat sa mas mataas na tiwala na uri ng proxy para sa flow na iyon, o baguhin ang path. I-reserve ang captcha solving para sa maliliit, mataas na halaga na segments.
Q7: Paano ko masisiguro ang geo accuracy para sa localized content?
- I-validate ang IP region bago ang bawat batch at sample pages para sa mga language o currency markers. Panatilihin ang isang maliit na control list ng mga kilalang geo-locked pages upang mabilis na makita ang drift.
Mga Pagninilay at Susunod na Hakbang
Ang pagbabalansi ng stability at scale ay hindi isang one-time setting. Ito ay isang loop: probe, measure, adjust. Ang mga datacenter pools ay nagbibigay ng cost-effective throughput sa mga tolerant na target. Ang mga residential networks ay nagpapabuti sa session stability sa mas mahihirap na target. Ang winning setup ay tumutugma sa uri ng proxy, concurrency, at rotation sa pressure ng bawat domain.
Mga susunod na hakbang:
- Magpatakbo ng dalawang linggong pilot sa iyong top five domains gamit ang parehong uri ng proxy.
- Subaybayan ang success rate, block rate, session stability, geo accuracy, at CPSR.
- I-lock ang guardrails kung saan lumiliko ang curves, pagkatapos ay mag-scale nang dahan-dahan.
Para sa mas malalim na pag-aaral, tuklasin ang mga teknikal na resources ng SquidProxies tungkol sa mga uri ng proxy, use cases, at mga pattern ng implementasyon. Kung kailangan mong i-brief ang iyong team, ibahagi ang gabay na ito at simulan ang isang maliit na benchmark plan ngayon. Ang tamang proxies para sa AI data collection ay magpapakita bilang mas mababang CPSR, mas kaunting alerto, at mas matatag na data freshness.
Mga Kaugnay na Artikulo
MostLogin: Ang Premier Anti-Detect Browser para sa Seamless Multi-Account Management at Automation
Ang MostLogin ay isang anti-detect browser na dinisenyo para sa secure na pamamahala ng maraming account, pag-iisa ng browser profile, integration ng proxy, automation, at kolaborasyon ng team. Sinusuportahan nito ang mga use case sa e-commerce, social media, affiliate marketing, advertising, at iba pang multi-profile workflows.
Gabay sa Inprastruktura ng Pagsubaybay sa Presyo ng E-Commerce
Isang praktikal at metrics-driven na gabay sa pagdidisenyo, pagpapatakbo, at pag-scale ng e-commerce price monitoring infrastructure para sa mga marketing, SEO, at data teams.
Local SEO Monitoring gamit ang Residential Proxies: Tumpak na Geo-Results sa Malawak na Saklaw
Isang praktikal na gabay sa pagpapatakbo ng location-accurate na SERP at map monitoring gamit ang residential proxies. Alamin ang tungkol sa architecture, routing choices, metrics, failure modes, at isang decision framework na ginawa para sa mga ahensya, brand, at data teams.