 Live Chat
 Mag-log In


Scrapy Middleware Optimization para sa Malalaking Proxy Pools
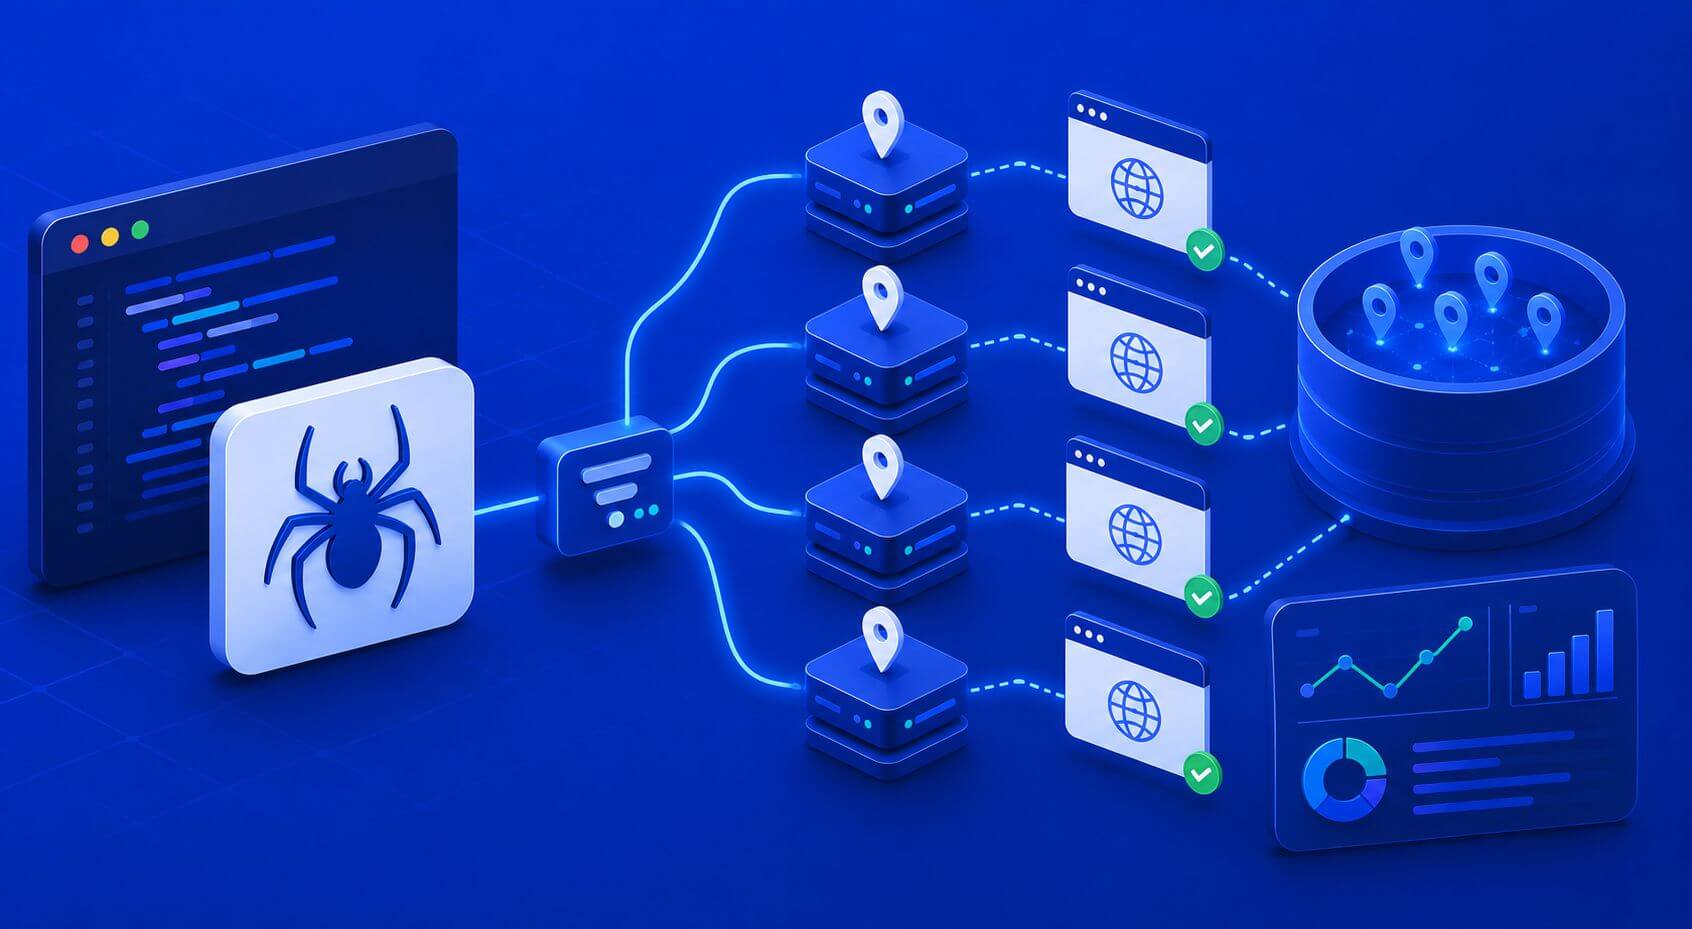
Bihirang bumagsak ang malalaking sistema ng scraping dahil hindi makapagpadala ng mga request ang scraper mismo. Bumagsak sila dahil nagiging hindi matatag ang proxy layer sa ilalim ng concurrency, retries, hindi pare-parehong session handling, o mahihirap na desisyon sa routing. Ang optimization ng Scrapy middleware ay tumutulong upang malutas ang mga problemang ito sa pamamagitan ng pagkontrol kung paano gumagalaw ang mga request sa proxy pools, kung paano ikinoklasipika ang mga pagkakamali, at kung paano ipinamamahagi ang mga session sa mga target.
Para sa mga team na namamahala ng malalaking proxy pools, ang middleware ay nagiging control layer sa pagitan ng scraper at ng network. Ang maayos na disenyo ng middleware strategy ay nagpapabuti sa throughput, nagpapababa ng block rates, nagbabawas ng nasayang na retries, at pinapanatili ang mga gastos sa proxy sa ilalim ng kontrol. Ang layunin ay hindi lamang ang mabilis na pag-ikot ng mga IP. Ang layunin ay mapanatili ang matatag, wastong output sa malaking sukat.
Bakit mahalaga ang middleware sa Scrapy proxy systems
Ang Scrapy ay ginawa para sa scalable asynchronous crawling. Kaya nitong hawakan ang mataas na concurrency nang mahusay, ngunit ang malakihang scraping ay mabilis na nagdudulot ng pressure sa proxy layer.
Kung walang wastong kontrol ng middleware, lumilitaw ang mga karaniwang problema:
- ang parehong proxy ay labis na nagagamit
- ang retries ay walang katapusang umiikot
- ang mga unhealthy routes ay nananatiling aktibo
- ang consistency ng session ay nababasag
- ang latency ay tumataas sa buong pool
- ang dalas ng CAPTCHA ay tumataas
- ang ilang rehiyon ay nagiging overloaded
- ang gastos bawat matagumpay na resulta ay tumataas
Ito ang dahilan kung bakit ang Scrapy middleware ay hindi lamang dapat mag-inject ng proxies. Dapat nitong aktibong pamahalaan ang routing logic, health scoring, retry policies, concurrency balancing, at failure classification.
Ano ang talagang ginagawa ng Scrapy downloader middleware
Ang Scrapy downloader middleware ay nakaupo sa pagitan ng Scrapy engine at ng outbound requests.
Maaari itong:
- mag-assign ng proxies
- magbago ng headers
- mag-rotate ng sessions
- humawak ng retries
- subaybayan ang mga pagkakamali
- mag-apply ng throttling
- iklasipika ang mga responses
- pamahalaan ang authentication
- i-adjust ang routing policies nang dinamiko
Para sa malalaking proxy pools, ang middleware ay nagiging operational brain ng scraper.
Sa halip na basta-basta na nagpapadala ng mga request sa pamamagitan ng random proxies, pinapayagan ng middleware ang sistema na magpasya:
- aling proxy ang dapat humawak ng request
- kailan dapat magpahinga ang isang proxy
- kailan dapat manatiling sticky ang isang session
- kailan dapat alisin ang isang nabigong route
- kailan kinakailangan ang residential routing
- kailan sapat na ang mas mababang gastos na routes
Direktang sagot: paano mo i-optimize ang Scrapy middleware para sa malalaking proxy pools?
I-optimize ang Scrapy middleware sa pamamagitan ng paghihiwalay ng proxy selection mula sa retry logic, pagsubaybay sa proxy health scores, paglimita sa retries ayon sa uri ng pagkakamali, pagbalanse ng concurrency sa mga routes, at paggamit ng sticky sessions lamang kapag kinakailangan ang continuity ng workflows. Ang pinakamahusay na mga sistema ay itinuturing ang proxy pools bilang dynamic infrastructure sa halip na static IP lists.
Ang pinakamalaking pagkakamali sa disenyo ng proxy middleware
Maraming scraping systems ang gumagamit ng simpleng random rotation:
proxy = random.choice(proxy_list)
Ito ay gumagana sa maliit na sukat ngunit nagiging hindi matatag kapag tumaas ang concurrency.
Bakit?
Dahil ang random selection ay hindi isinasaalang-alang:
- kalusugan ng proxy
- kamakailang kasaysayan ng pagkakamali
- latency
- sensitivity ng target
- geo alignment
- persistence ng session
- lalim ng retry
- pressure ng concurrency
Sa malaking sukat, ang middleware ay dapat maging policy-driven sa halip na random.
Ang perpektong arkitektura para sa malalaking proxy pools
Ang scalable na Scrapy proxy architecture ay karaniwang naglalaman ng limang layer.
1. Proxy pool manager
Ang proxy pool manager ay nag-iimbak ng lahat ng aktibong proxies at metadata:
- IP
- rehiyon
- ASN
- uri ng proxy
- kasaysayan ng pagkakamali
- latency
- cooldown state
- kakayahan ng session
- success rate
Ang pool manager ay hindi dapat paulit-ulit na magbigay ng mga unhealthy proxies.
2. Middleware routing layer
Ang middleware routing layer ay nagpasya kung aling proxy ang dapat humawak ng bawat request.
Ang mga desisyon sa routing ay maaaring umasa sa:
- domain
- uri ng request
- geo requirement
- account session
- anti-bot sensitivity
- concurrency limits
- kamakailang pattern ng block
Ito ay pumipigil sa parehong strategy na mailapat sa lahat ng target.
Hindi lahat ng pagkabigo ay nangangahulugang "agad na mag-rotate."
Dapat i-classify ng middleware ang:
- 403 errors
- 429 rate limits
- CAPTCHA pages
- soft blocks
- timeouts
- geo mismatches
- empty responses
- DNS failures
- TLS issues
Bawat uri ng pagkabigo ay maaaring mangailangan ng ibang tugon.
Halimbawa:
| Uri ng pagkabigo | Inirerekomendang aksyon |
|---|---|
| Timeout | Ulitin sa parehong rehiyon |
| 403 | Palitan ang uri ng proxy |
| CAPTCHA | Bawasan ang concurrency |
| Soft block | I-validate ang session |
| Geo mismatch | Palitan ang lokasyon |
| DNS failure | Alisin ang ruta pansamantala |
Ito ay nakakaiwas sa hindi kinakailangang proxy churn.
4. Sistema ng health scoring
Bawat proxy ay dapat makatanggap ng health score batay sa:
- matagumpay na mga tugon
- kamakailang pagkabigo
- latency
- retry depth
- dalas ng CAPTCHA
- tagal ng session
Ang mga malusog na proxy ay nananatiling aktibo nang mas matagal. Ang mga mahihinang ruta ay nag-cool down nang awtomatiko.
Ito ay malapit na nauugnay sa mas malawak na proxy pool architecture na mga estratehiya kung saan ang layunin ay pangmatagalang katatagan, hindi agresibong pag-ikot.
5. Metrics at monitoring layer
Kung walang monitoring, ang tuning ng middleware ay nagiging hulaan.
Subaybayan:
- success rate
- block rate
- CPSR
- latency
- retry depth
- requests per proxy
- session duration
- geo accuracy
- dalas ng soft block
Ipinapakita ng mga metrics na ito kung ang middleware ay nagpapabuti ng wastong output o simpleng nagpapataas ng dami ng request.
Datacenter vs residential routing sa loob ng middleware
Ang malalaking sistema ay hindi dapat ituring na pantay-pantay ang bawat request.
Para sa mga lower-friction na pahina, ang datacenter proxies ay maaaring magbigay ng mas mabilis at mas murang throughput.
Para sa mga sensitibong daloy, ang residential proxies ay kadalasang nagpapabuti:
- tagal ng session
- consistency ng geo
- pagiging maaasahan ng login
- anti-bot resistance
- localized rendering
Dapat magdesisyon ang middleware kung aling uri ng ruta ang gagamitin batay sa workload.
Ang isang praktikal na hybrid na estratehiya ay ganito:
| Uri ng request | Inirerekomendang ruta |
|---|---|
| Discovery crawling | Datacenter |
| Product rendering | Residential |
| Login flow | Residential sticky |
| Search monitoring | Residential geo-specific |
| URL validation | Datacenter |
| CAPTCHA recovery | Residential fallback |
Ito ay nagpapanatili ng mahal na residential traffic na nakatuon kung saan ito nagpapabuti ng mga resulta.
Halimbawa: simpleng rotating middleware
Basic na estruktura ng middleware:
import random

class ProxyMiddleware:

    def __init__(self, proxies):
        self.proxies = proxies

    @classmethod
    def from_crawler(cls, crawler):
        return cls(
            proxies=crawler.settings.get('PROXY_LIST')
        )

    def process_request(self, request, spider):
        proxy = random.choice(self.proxies)
        request.meta['proxy'] = proxy
Ito ay gumagana para sa maliliit na sistema ngunit walang health tracking, failure handling, o concurrency awareness.
Halimbawa: health-aware proxy middleware
Mas magandang diskarte ang nagtatala ng kalidad ng proxy.
class ProxyPool:

    def __init__(self):
        self.proxies = {}

    def get_best_proxy(self):
        healthy = sorted(
            self.proxies.items(),
            key=lambda x: x[1]['score'],
            reverse=True
        )

        return healthy[0][0]

    def mark_failure(self, proxy):
        self.proxies[proxy]['score'] -= 1

    def mark_success(self, proxy):
        self.proxies[proxy]['score'] += 1
Ito ay lumilikha ng adaptive routing sa halip na bulag na pag-ikot.
Ang mga production systems ay kadalasang nagdadagdag ng:
- cooldown windows
- regional balancing
- proxy type weighting
- domain-specific health
- session grouping
- retry budgets
Mga estratehiya sa optimization ng middleware na talagang nagpapabuti ng performance
Gumamit ng domain-aware routing
Iba't ibang domain ang may iba't ibang tugon sa proxy behavior.
Maaaring tanggapin ng isang target ang datacenter traffic nang madali. Ang isa naman ay maaaring mangailangan ng residential routing para sa mas matatag na resulta.
Dapat i-assign ng middleware ang routing policy batay sa domain sa halip na globally.
Ihiwalay ang retry logic mula sa rotation logic
Hindi laging nangangailangan ng bagong proxy ang isang retry.
Minsan:
- pansamantala ang timeout
- bumagal ang target
- nag-stall ang browser
- nabigo ang request mismo
Ang bulag na pag-ikot pagkatapos ng bawat pagkabigo ay nagdaragdag ng kawalang-stabilidad.
Mag-apply ng proxy cooldowns
Kapag ang isang proxy ay paulit-ulit na nabigo, pansamantala itong alisin mula sa rotation sa halip na permanenteng tanggalin ito.
Ang cooldown windows ay tumutulong upang maiwasan ang paulit-ulit na retries sa mga unhealthy routes.
Limitahan ang concurrency per proxy
Isang magandang proxy ay maaari pa ring mabigo kung overloaded.
Dapat ipamahagi ng middleware ang concurrency sa buong pool sa halip na ituon ang mga request sa mga kamakailang matagumpay na ruta.
Panatilihin ang sticky sessions lamang kung kinakailangan
Pinapabuti ng sticky sessions ang continuity ngunit binabawasan ang flexibility ng pool.
Gamitin ang mga ito para sa:
- login workflows
- pagination
- carts
- account-based browsing
Iwasan ang hindi kinakailangang stickiness para sa mga independent pages.
Ano ang dapat i-monitor bago mag-scale
Ang malalaking proxy pools ay dapat sukatin batay sa usable output, hindi sa raw request count.
Maingat na subaybayan ang mga metric na ito.
Success rate
Porsyento ng mga request na nagbabalik ng valid na data.
Block rate
403, 429, CAPTCHA, challenge pages, o bans.
Soft block rate
Mga pahina na technically ay naglo-load ngunit nagbabalik ng hindi kumpleto o maling data.
Retry depth
Ilang retries ang kinakailangan para sa isang matagumpay na resulta.
Proxy utilization
Gaano ka-even ang pamamahagi ng mga request sa buong pool.
Session survival
Gaano katagal nananatiling usable ang isang session bago ang degradation.
CPSR
Cost per successful request.
CPSR = total infrastructure cost / successful validated outputs.
Sa simpleng salita: Sinusukat ng CPSR kung magkano ang halaga ng bawat usable result pagkatapos ng retries, compute, at proxy spend.
Real-world scenario: eCommerce scraping infrastructure
Isang eCommerce team ang nagpapatakbo ng 500 concurrent Scrapy workers sa iba't ibang marketplaces.
Ang unang bersyon ay gumagamit ng random rotation at global retries. Tumataas ang block rate sa panahon ng peak traffic dahil ang parehong residential routes ay paulit-ulit na na-o-overload.
Ang pinabuting middleware ay nagpakilala ng:
- domain-specific routing
- per-proxy concurrency caps
- cooldown windows
- regional balancing
- health scoring
Ang resulta ay mas kaunting retries at mas mababang CPSR sa kabila ng paggamit ng mas kaunting kabuuang proxies.
Real-world scenario: SERP monitoring
Isang SEO platform ang kumokolekta ng localized search results sa iba't ibang rehiyon.
Ang random rotation ay nagdudulot ng region mismatch at hindi matatag na rankings.
Ang optimized middleware ay nagbubuklod:
- isang rehiyon
- isang session
- isang request group
- isang residential route
Ito ay nagbubunga ng mas matatag na localized results at nagpapababa ng false ranking variance.
Karaniwang pagkakamali sa middleware optimization
Paggamot sa lahat ng pagkabigo nang pareho
Ang 403, timeout, CAPTCHA, at geo mismatch ay hindi dapat mag-trigger ng magkaparehong retry behavior.
Over-rotating proxies
Ang agresibong rotation ay madalas na nagdudulot ng higit pang kawalang-stabilidad sa halip na mas kaunting blocks.
Pagwawalang-bahala sa soft blocks
Ang matagumpay na HTTP status code ay hindi nangangahulugang usable ang content.
Paggamit ng isang routing policy globally
Bawat domain ay may iba't ibang pag-uugali. Dapat umangkop ang routing batay sa target.
Pag-overload sa mga high-performing proxies
Ang matagumpay na proxies ay madalas na tumatanggap ng sobrang traffic at mabilis na bumababa ang performance.
Pagsusukat ng request volume sa halip na usable output
Hindi laging nangangahulugang mas maraming request ay mas maraming halaga. Subaybayan ang validated output sa halip.
Cost optimization para sa malalaking proxy pools
Ang malalaking proxy systems ay nagiging mahal kapag ang retries ay tumataas nang hindi makontrol.
Ang middleware optimization ay nagpapababa ng gastos sa pamamagitan ng:
- pagbabawas ng nasayang na retries
- pagpapabuti ng session survival
- epektibong pamamahagi ng load
- pag-iwas sa hindi kinakailangang residential routing
- pagpapababa ng frequency ng CAPTCHA
- pagpapabuti ng kalidad ng request success
Para sa mas malawak na mga pattern ng implementasyon, pagsamahin ang optimization ng middleware sa mga umiiral na proxy tutorials upang manatiling pare-pareho ang pag-uugali ng proxy sa iba't ibang framework at mga koponan.
Paano umunlad ang middleware sa paglipas ng panahon
Huwag i-optimize ang lahat nang sabay-sabay.
Isang praktikal na pag-unlad:
- Magsimula sa simpleng rotation.
- Magdagdag ng health scoring.
- Ihiwalay ang retry logic.
- Magdagdag ng domain-specific routing.
- Ipakilala ang concurrency balancing.
- Subaybayan ang CPSR.
- Magdagdag ng adaptive policy tuning.
Ito ay nakakapigil sa overengineering bago mo maunawaan ang target na pag-uugali.
Mga Madalas Itanong
Ano ang gamit ng Scrapy middleware sa mga proxy system?
Ang Scrapy middleware ay kumokontrol kung paano pinoproseso ang mga request bago umalis sa scraper. Sa mga proxy system, ang middleware ay maaaring pamahalaan ang rotation, retries, authentication, routing, health scoring, at failure handling.
Dapat bang i-rotate ng Scrapy ang mga proxy sa bawat request?
Hindi palagi. Ang mga independent requests ay maaaring mag-rotate nang mas agresibo, ngunit ang mga session-based workflows ay kadalasang nangangailangan ng sticky routing. Ang rotation ay dapat tumugma sa target na pag-uugali.
Bakit bumabagsak pa rin ang malalaking proxy pools?
Bumabagsak ang malalaking pools kapag ang concurrency, retries, routing, o session handling ay hindi maayos na pinamamahalaan. Ang mas maraming proxies ay hindi garantiya ng katatagan.
Anong uri ng proxy ang pinaka-angkop sa Scrapy?
Ang mga datacenter proxies ay kadalasang mahusay para sa mga lower-friction pages at discovery crawling. Ang mga residential proxies ay karaniwang mas mahusay para sa mga protected, geo-sensitive, o session-heavy workflows.
Paano mo mababawasan ang CPSR sa malalaking scraping systems?
Bawasan ang retries, maayos na ipamahagi ang concurrency, tamaan ang mga pagkakamali, at gumamit ng residential routing lamang kung ito ay nagpapabuti sa valid output.
Ano ang dapat kong subaybayan sa Scrapy middleware?
Subaybayan ang success rate, block rate, latency, retry depth, session survival, proxy utilization, geo accuracy, at CPSR.
Pangwakas na mga Saloobin
Ang optimization ng Scrapy middleware ay sa huli tungkol sa kontrol. Ang malalaking proxy pools ay nagiging matatag kapag ang routing, retries, concurrency, at session handling ay nagtutulungan sa halip na kumilos nang hiwalay.
Ang pinakamalalakas na sistema ay itinuturing ang mga proxy bilang dynamic infrastructure, hindi static IP lists. Sila ay nag-route nang matalino, tama ang pag-classify ng mga pagkakamali, at nag-scale lamang pagkatapos sukatin ang kalidad ng valid output.
Para sa malalaking scraping teams, ang optimization ng middleware ay isa sa mga pinakamataas na leverage improvements na available dahil ito ay nakakaapekto sa katatagan, pagganap, at gastos sa infrastructure nang sabay-sabay.
Mga Kaugnay na Artikulo
Mga Estratehiya sa Pag-ikot ng Selenium Proxy na Talagang Epektibo
Alamin ang mga praktikal na estratehiya sa Selenium proxy rotation na talagang epektibo para sa browser automation, scraping, SEO monitoring, at mga workflow na nakabatay sa account. Saklaw ng gabay na ito ang residential vs datacenter proxies, sticky sessions, browser-session alignment, rotation timing, mga halimbawa na handa na para sa produksyon, at ang mga pangunahing metrics na dapat subaybayan ng mga team upang mabawasan ang mga block at mapabuti ang pagiging maaasahan ng automation.
Paano Gamitin ang Residential Proxies sa Puppeteer
Alamin kung paano gamitin ang residential proxies kasama ang Puppeteer para mapabuti ang katatagan ng browser automation, mabawasan ang block rates, at mas epektibong hawakan ang mga geo-sensitive o login-based workflows. Saklaw ng gabay na ito ang proxy configuration, sticky sessions, browser contexts, rotation strategies, CPSR optimization, at mga best practices na handa na para sa produksyon para sa scalable na Puppeteer automation.