 Live Chat
 Mag-log In


Headless vs Headful Browsers sa Modernong Scraping: Paano Pumili
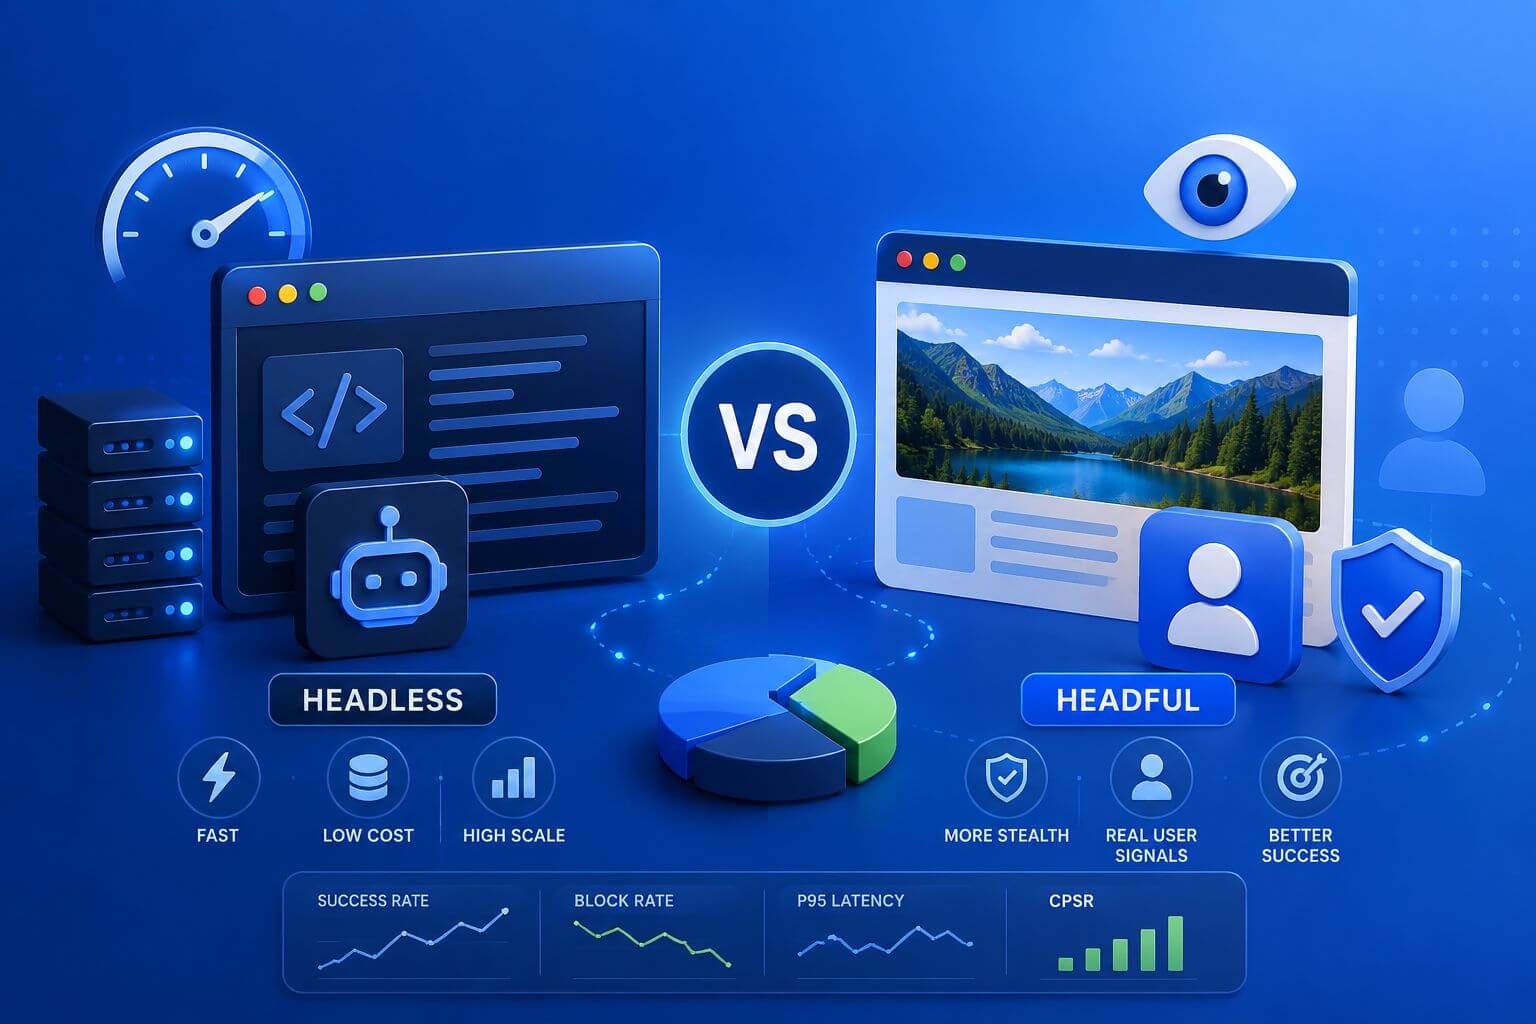
Ang isang scraper ay maaaring mukhang matatag sa development ngunit maaaring mabigo sa production kapag pumasok na ang mga tunay na target, mas mataas na concurrency, browser fingerprinting, at proxy routing. Isa sa mga unang desisyon na hinaharap ng mga team ay kung gagamit ba ng headless o headful na mga browser. Ang pagpili na ito ay nakakaapekto sa success rate, block rate, latency, infrastructure cost, at CPSR.
Ang headless vs headful na mga browser ay hindi isang simpleng desisyon na "alin ang mas mabuti?" Ang mga headless na browser ay tumatakbo nang walang nakikitang user interface at kadalasang mas mabilis, mas magaan, at mas madaling i-scale. Ang mga headful na browser ay tumatakbo na may nakikitang browser window at maaaring kumilos na mas malapit sa isang tunay na user environment, na maaaring makatulong sa mas mahigpit na mga target na may maraming fingerprint. Ang pinakamahusay na setup ay kadalasang gumagamit ng pareho: headless para sa dami at headful para sa sensitibong mga daloy.
Para sa mga team na bumubuo ng scraping o automation workflows, ang mode ng browser ay dapat ituring na isang desisyon sa routing. Gamitin ang pinakamababang-cost mode na patuloy na nagbabalik ng wastong data, pagkatapos ay mag-escalate lamang kapag ang mga depensa ng target ay nagjustify ng karagdagang gastos.
Ano ang Ibig Sabihin ng Headless at Headful na Mga Browser
Ang headless na browser ay isang tunay na browser engine na tumatakbo nang walang nakikitang window. Maaari itong mag-load ng mga pahina, mag-execute ng JavaScript, mag-render ng DOM content, mag-click ng mga button, magsumite ng mga form, at mag-extract ng data nang hindi ipinapakita ang browser UI.
Ang headful na browser ay tumatakbo na may nakikitang interface, mas malapit sa kung paano normal na binubuksan ng isang user ang Chrome, Firefox, o ibang browser sa isang device.
Parehong mode ay available sa mga karaniwang automation tools tulad ng Playwright, Puppeteer, at Selenium. Ang pagkakaiba ay hindi kung ang browser ay "tunay." Ang pagkakaiba ay kung paano ipinapakita ng browser ang rendering, window, graphics, timing, at system-level signals.
Ang modernong headless Chromium ay mas malapit sa headful Chromium kaysa sa mga mas lumang headless builds. Nakakatulong ito na bawasan ang mga halatang detection gaps, ngunit hindi nito inaalis ang pangangailangan para sa wastong session design, fingerprint alignment, at proxy strategy.
Mabilis na Desisyon: Kailan Gagamitin ang Headless vs Headful na Mga Browser
Gamitin ang headless na mga browser kapag ang bilis, scale, at mas mababang infrastructure cost ay mas mahalaga kaysa sa maximum browser realism. Gamitin ang headful na mga browser kapag ang workflow ay login-heavy, fingerprint-sensitive, o paulit-ulit na nabibigo sa headless mode sa kabila ng malinis na proxies at makatwirang pacing.
Isang praktikal na tuntunin ay simple:
Magsimula sa headless, sukatin nang maingat, pagkatapos ay mag-escalate sa headful lamang para sa mga target o workflows na nagjustify nito.
| Workload | Inirerekomendang Mode | Bakit |
|---|---|---|
| Static public pages | Headless | Mas mababang gastos, mas mabilis na throughput |
| JavaScript-rendered pages | Headless muna | Kadalasang sapat na gamit ang modern engines |
| Product and price monitoring | Headless o hybrid | Headless para sa malawak na koleksyon, headful para sa mas mahirap na mga target |
| Login-based dashboards | Headful o maingat na na-tune na headless | Mas magandang session realism ang maaaring mahalaga |
| Marketplace account workflows | Headful | Mas sensitibo sa fingerprints at session behavior |
| Geo-targeted testing | Headless muna | Mas mabilis na profile at location rotation |
| Strict anti-bot environments | Headful test cohort | Kapaki-pakinabang kapag paulit-ulit na nabibigo ang headless |
| High-volume URL validation | Headless | Scale at control ng gastos ang pinakamahalaga |
Pinapanatili ng framework na ito ang mga gastos sa imprastruktura na kontrolado habang pinapanatili ang opsyon na gumamit ng headful browsers kung saan ito ay nagpapabuti sa tagumpay.
Bakit Nakakaapekto ang Browser Mode sa Pagkakatiwalaan ng Scraping
Hindi lamang ang mga website ang sumusuri sa mga IP address. Sinasaliksik din nila ang pag-uugali ng browser, mga signal ng graphics, mga property na nakalantad sa JavaScript, timing, cookies, storage, at consistency ng network.
Iyan ang dahilan kung bakit ang isang scraping stack na gumagamit ng magandang web scraping proxies ay maaari pa ring mabigo kung ang kapaligiran ng browser ay mukhang hindi pangkaraniwan.
Ang headless mode ay maaaring matukoy kapag ang mga default ay hindi makatotohanan, lipas na, o hindi tumutugma sa natitirang bahagi ng session. Ang headful mode ay maaaring mabawasan ang ilan sa mga puwang na iyon, ngunit hindi ito isang magic solution. Ang masamang reputasyon ng proxy, geo mismatch, agresibong concurrency, o sirang cookies ay maaari pa ring magdulot ng mga block.
Ang browser mode ay isang layer. Ang proxy strategy, session handling, fingerprint consistency, at content validation ay nagtutulungan.
Ang Pangunahing Tradeoff: Bilis, Realismo, at Gastos
Karaniwan, ang mga headless browsers ay mas mahusay dahil iniiwasan nila ang overhead ng isang nakikitang UI. Mas madali silang patakbuhin sa mga container, mas madaling i-parallelize, at mas angkop para sa mataas na dami ng pagkolekta ng data.
Ang mga headful browsers ay mas mabigat. Kumakain sila ng mas maraming CPU at memory, mas mabagal tumakbo sa scale, at kadalasang nangangailangan ng mas maingat na imprastruktura. Ngunit para sa ilang mga target, ang idinagdag na realismo ay maaaring magpabuti sa pagpapanatili ng session.
Ang tradeoff ay dapat sukatin sa pamamagitan ng:
- Rate ng tagumpay
- Rate ng block
- Rate ng CAPTCHA
- Retry depth
- P95 latency
- Paggamit ng resources
- Pagpapanatili ng session
- CPSR
Ang CPSR ay nangangahulugang cost per successful request.
Sa simpleng salita: sinasabi sa iyo ng CPSR kung magkano ang halaga ng bawat wastong resulta pagkatapos ng gastos sa proxy, compute, retries, at nabigong sessions.
Ang isang headful browser ay nagkakahalaga ng dagdag na gastos lamang kapag pinabuti nito ang wastong output nang sapat upang ma-offset ang idinagdag na gastos sa imprastruktura.
Paano Pumapasok ang Proxies sa Desisyon
Ang browser mode at uri ng proxy ay dapat piliin nang magkasama.
Para sa mga pampublikong pahina na may mas mababang friction, ang datacenter proxies ay maaaring gumana nang maayos sa mga headless browsers. Ang setup na ito ay kadalasang mabilis, paulit-ulit, at cost-efficient.
Para sa mga protektado, geo-sensitive, o session-heavy na daloy, ang residential proxies ay maaaring mas angkop. Ang mga residential routes ay maaaring magpabuti sa network realism, habang ang headful o maingat na na-tune na mga session ng browser ay nagpapabuti sa consistency sa client-side.
Ang isang karaniwang pattern ng produksyon ay mukhang ganito:
| Target Type | Browser Mode | Proxy Strategy |
|---|---|---|
| Pampublikong kategoryang pahina | Headless | Datacenter proxies |
| Mga pahina ng detalye ng produkto | Headless first | Datacenter o residential fallback |
| Mga daloy ng pag-login | Headful o persistent headless | Sticky residential proxy |
| Localized content | Headless first | Residential proxy by GEO |
| Mataas na friction na mga pahina | Headful test group | Residential proxy with stable session |
| Malawak na discovery crawling | Headless | Datacenter proxies with rotation |
Pinipigilan nito ang mga koponan na gumamit ng pinakamahal na setup sa lahat ng dako.
Headless Detection: Ano ang Talagang Na-flag
Ang headless detection ay bihirang bumaba sa isang signal. Karamihan sa mga modernong sistema ay pinagsasama ang maraming mga indicator.
Kadalasang mga isyu ay kinabibilangan ng:
navigator.webdriverexposure- hindi makatotohanang viewport size
- nawawalang fonts
- kakaibang WebGL vendor o renderer
- hindi pare-parehong User-Agent at OS signals
- nawawalang plugins o media devices
- labis na perpektong timing
- hindi pangkaraniwang TLS o HTTP behavior
- walang cookie history
- WebRTC mismatch
- mataas na request velocity
Ang ilan sa mga ito ay may kinalaman sa browser-mode. Ang iba naman ay dulot ng hindi magandang disenyo ng profile, hindi tugmang proxy, o pag-uugali ng automation.
Para sa mas malalim na pagsusuri ng mga client-side signals, suriin ang browser fingerprinting for web scraping. Ipinaliwanag nito kung aling mga signal ang kayang ayusin ng mga proxy at kung aling mga signal ang dapat hawakan sa browser layer.
Kailan Angkop ang Headless Browsers
Ang mga headless browsers ay karaniwang pinakamahusay na panimulang punto para sa mga scraping teams.
Gumamit ng headless kapag:
- ang mga pahina ay pampubliko
- hindi kinakailangan ang pag-login
- kinakailangan ang JavaScript rendering ngunit hindi ito labis na protektado
- mahalaga ang mataas na throughput
- dapat manatiling mababa ang gastos sa imprastruktura
- maikli ang mga session ng browser
- tuwid ang pag-validate ng data
Ang headless ay lalong praktikal para sa eCommerce monitoring, SEO checks, URL validation, pampublikong page rendering, at malalaking discovery crawls.
Kung ang target ay nagbabalik ng wastong nilalaman na may mababang retries at katanggap-tanggap na latency, dapat manatiling default ang headless.
Kailan Dapat Subukan ang Headful Browsers
Ang mga headful browsers ay dapat subukan kapag ang workflow ay kumikilos na parang tunay na paglalakbay ng gumagamit.
Gumamit ng headful kapag:
- kinakailangan ang pag-login o SSO
- sinusuri ng site ang pag-uugali ng graphics o media
- ang mga headless session ay paulit-ulit na nag-trigger ng CAPTCHA
- ang mga pahina ay bumabagsak pagkatapos ng interaksyon, hindi sa unang pag-load
- mahalaga ang mga long-lived sessions
- mataas ang anti-bot friction
- kasangkot ang mga account-based workflows
Maaaring makatulong ang headful mode dahil maaari nitong ipakita ang mas natural na kapaligiran ng browser. Gayunpaman, dapat itong subukan sa isang kontroladong subset bago ang rollout.
Huwag ilipat ang lahat sa headful dahil lamang sa isang target ang nabigo.
Isang Praktikal na Daan ng Pagsusuri
Gumamit ng daang ito bago gumawa ng magastos na pagbabago sa imprastruktura.
- Magsimula sa modernong headless mode.
- I-validate ang nilalaman ng pahina, hindi lamang ang HTTP status.
- I-tune ang viewport, timezone, wika, at session storage.
- I-align ang lokasyon ng proxy sa profile ng browser.
- Bawasan ang concurrency at retry pressure.
- Subukan ang sticky sessions.
- Ihambing ang headless laban sa headful sa parehong target.
- Ilipat lamang ang mga nabigong segment sa headful.
Ang pamamaraang ito ay nagpoprotekta sa CPSR habang pinapabuti ang pagiging maaasahan kung saan ito mahalaga.
Mga Tala sa Implementasyon para sa Playwright, Puppeteer, at Selenium
Playwright
Ang Playwright ay madalas na isang mahusay na pagpipilian para sa modernong scraping dahil sinusuportahan nito ang Chromium, Firefox, at WebKit. Madali rin nitong pinapadali ang pag-isolate ng mga browser contexts.
Gumamit ng hiwalay na mga context para sa iba't ibang account, GEOs, o uri ng session. Panatilihing pare-pareho ang proxy routing, timezone, wika, at storage sa loob ng bawat context.
Puppeteer
Ang Puppeteer ay isang magandang akma para sa Chromium-based scraping at automation. Ito ay magaan, malawak na ginagamit, at angkop para sa headless-first workflows.
Kapag gumagamit ng Puppeteer, mag-ingat sa launch flags, viewport defaults, at proxy configuration. Ang maliliit na inconsistency ay maaaring maging halata sa malaking sukat.
Selenium
Ang Selenium ay karaniwang ginagamit kapag ang mga teams ay nangangailangan ng malawak na suporta sa browser, legacy flows, o interaction-heavy automation.
Para sa mga login-heavy workflows, maaaring maging kapaki-pakinabang ang Selenium na may headful browser, ngunit dapat itong masubaybayan nang mabuti para sa paggamit ng resources at katatagan ng session.
Resource Blocking: Kapaki-pakinabang ngunit Panganib
Ang pag-block ng mga imahe, font, analytics scripts, o third-party trackers ay maaaring magpababa ng gastos at pabilisin ang scraping.
Ngunit ang agresibong resource blocking ay maaari ring makasira sa lohika ng pahina o mga palagay sa detection.
Para sa mga headless workflows, kapaki-pakinabang ang resource blocking kapag:
- ang target na pahina ay patuloy na nagre-render nang tama
- ang mga kinakailangang script ay nananatiling naka-enable
- ang pag-validate ay nagkukumpirma ng kumpletong data
- ang blocking ay hindi nag-trigger ng anti-tamper behavior
Para sa mga headful workflows, maging mas maingat. Kung ang layunin ay realism, ang sobrang pag-alis ng maraming resources ay maaaring gawing hindi natural ang session.
Ano ang Dapat Sukatin Bago Mag-Scale
Ang desisyon sa browser-mode ay dapat batay sa data.
Subaybayan ang mga metric na ito:
| Metric | Bakit Ito Mahalaga |
|---|---|
| Success rate | Tinitiyak ang magagamit na output |
| Block rate | Ipinapakita ang pagtutol ng target |
| CAPTCHA rate | Madalas na nagpapahiwatig ng fingerprint o isyu sa pag-uugali |
| Soft block rate | Nahuhuli ang mga pahina na naglo-load pero nagbabalik ng maling data |
| Retry depth | Ipinapakita ang nakatagong hadlang |
| P95 latency | Pinoprotektahan ang pagiging bago at SLA targets |
| Session survival | Sinusukat ang katatagan ng mas mahabang workflows |
| CPU and memory per worker | Tinataya ang gastos sa imprastruktura |
| CPSR | Sinusukat ang tunay na gastos bawat magagamit na resulta |
Huwag umasa sa katayuan ng pahina lamang. Maaaring magbalik ang isang pahina ng 200 at mayroon pa ring nawawalang, maling, o hindi tugmang data sa rehiyon.
Tunay na Senaryo: Pagsubaybay sa Presyo ng eCommerce
Isang team ng eCommerce ang nagmamanman ng libu-libong pahina ng produkto mula sa ilang retailer.
Nagsimula sila gamit ang headless Chromium at datacenter proxies para sa malawak na koleksyon. Karamihan sa mga retailer ay nagbabalik ng malinis na data ng produkto na may mababang latency.
Dalawang retailer ang nagsimulang magbalik ng soft blocks at nawawalang mga module ng presyo. Sa halip na ilipat ang buong sistema sa headful browsers, lumikha ang team ng hiwalay na ruta para sa mga domain na iyon gamit ang residential proxies at persistent browser contexts.
Ang resulta ay isang hybrid na sistema. Ang headless ang humahawak sa karamihan ng volume, habang ang mas mahihirap na target ay tumatanggap ng mas makatotohanan at mas mahal na setup lamang kung kinakailangan.
Tunay na Senaryo: Authenticated Travel Dashboard
Kailangan ng isang travel data team na mangolekta ng availability mula sa isang supplier portal na nangangailangan ng login.
Gumagana ang headless mode para sa login page ngunit nabibigo pagkatapos ng ilang interaksyon sa dashboard. Nag-reset ang mga session, at tumataas ang retry depth.
Sinubukan ng team ang headful Chromium gamit ang sticky residential proxies, matatag na browser profiles, at mas mabagal na pacing ng interaksyon. Bumuti ang session survival, at bumaba ang manual intervention.
Mas mataas ang gastos ng setup bawat session, ngunit bumuti ang CPSR dahil mas kaunti ang nabibigo na workflows.
Mag-ingat sa mga Paraan ng Pagkabigo na Ito
Paggamot sa Headful bilang Isang Unibersal na Solusyon
Maaaring mabigo ang headful mode kung mali ang proxies, locale, cookies, o timing.
Sobrang Paggamit ng Headful Browsers
Ang headful sa malaking sukat ay maaaring mabilis na magpataas ng gastos. Gamitin ito kung saan napatunayan ng metrics ang halaga.
Pagwawalang-bahala sa Browser Fingerprints
Ang mode lamang ay hindi naglutas ng mga problema sa fingerprint. Mahalaga pa rin ang User-Agent, WebGL, fonts, timezone, storage, at WebRTC.
Para sa mga isyu na tiyak sa WebRTC, suriin ang aming gabay sa WebRTC leaks.
Pag-block ng Sobrang Maraming Resources
Kung ang mga na-block na resources ay nagbabago sa karanasan ng pahina, maaaring mangolekta ang iyong scraper ng hindi kumpletong data o mag-trigger ng integrity checks.
Pag-scale Bago ang Baseline Testing
Maaaring itago ng maliliit na pagsubok ang mga pagkabigo sa produksyon. Mag-pilot gamit ang mga kinatawang target, volume, at GEOs.
Mga Pagsasaalang-alang sa Gastos at Imprastruktura
Karaniwang sumusuporta ang headless browsers sa mas mataas na concurrency bawat makina. Ginagawa nitong mas madali ang pag-scale para sa malawak na crawling at monitoring.
Kadalasang nangangailangan ang headful browsers ng mas maraming CPU, memory, at display-related dependencies. Sa mga cloud environment, maaaring kailanganin nila ng virtual displays o container configuration.
Isang magandang estratehiya sa gastos ay:
- Gumamit ng HTTP clients kung maaari.
- Gumamit ng headless browsers para sa JavaScript rendering.
- Gumamit ng headful browsers lamang para sa mahihirap na workflows.
- Gumamit ng residential proxies lamang kung saan pinapabuti ng network realism ang output.
- Panatilihin ang datacenter routes para sa mga tolerant, high-volume na pahina.
Ang layered approach na ito ay nagpoprotekta sa gastos habang pinapabuti ang coverage.
Pagsunod at Kalidad ng Data
Ang browser mode ay hindi nagbabago sa pangangailangan para sa responsableng pagkolekta ng data.
Dapat igalang ng mga koponan ang mga naaangkop na batas, mga tuntunin ng platform, mga kinakailangan sa privacy, at mga patakaran sa pamamahala sa loob. Panatilihin ang mga log ng aktibidad ng koleksyon, sundin ang mga limitasyon sa rate, at iwasan ang pagkolekta ng data na lampas sa naaprubahang saklaw.
Ang magandang pagsunod at magandang kalidad ng data ay madalas na nagtutulungan. Ang isang maingat at kontroladong scraper ay mas madaling i-audit at patakbuhin.
Mga Madalas Itanong
Ano ang pagkakaiba ng headless at headful na mga browser?
Ang headless na browser ay tumatakbo nang walang nakikitang UI. Ang headful na browser ay tumatakbo na may nakikitang bintana ng browser. Pareho silang maaaring gumamit ng tunay na mga engine ng browser, ngunit naglalabas sila ng iba't ibang rendering at mga signal sa antas ng sistema.
Madedetect ba ang headless mode?
Oo, maaari. Ang mga modernong headless na browser ay mas mahusay kaysa sa mga lumang bersyon, ngunit ang hindi magandang configuration, mga automation flag, hindi makatotohanang mga setting, o nawawalang mga tampok ng browser ay maaari pa ring magdulot ng pagdududa.
Mas mabuti ba ang headful para sa scraping?
Hindi. Ang headful ay maaaring makatulong sa mas mahigpit na mga target, ngunit ito ay mas mabagal at mas mahal. Gamitin lamang ito kapag ito ay nagpapabuti sa rate ng tagumpay, pagpapanatili ng session, o CPSR.
Dapat ba akong magsimula sa headless o headful?
Magsimula sa headless maliban kung ang workflow ay malinaw na nakatuon sa pag-login, nakabatay sa account, o sensitibo sa fingerprint. Mag-escalate sa headful lamang kapag ang mga pagsubok ay nagpapakita na ang headless ay hindi makapagbigay ng matatag, wastong mga resulta.
Mas mahalaga ba ang proxies kaysa sa browser mode?
Mahalaga ang pareho. Ang uri ng proxy ay nakakaapekto sa reputasyon ng IP, lokasyon, at pag-uugali ng network. Ang browser mode ay nakakaapekto sa mga signal sa client-side. Ang malalakas na sistema ng scraping ay nag-uugnay sa parehong mga layer.
Maaari bang tumakbo ang Playwright sa parehong headless at headful?
Oo. Sinusuportahan ng Playwright ang parehong mga mode at pinadali ang paghiwalay ng mga konteksto ng browser. Kapaki-pakinabang ito para sa pagsubok ng headless at headful na pag-uugali laban sa parehong target.
Maaari bang tumakbo ang Puppeteer sa headful mode?
Oo. Maaaring ilunsad ng Puppeteer ang Chromium sa headless o headful na mode. Ang headful na mode ay maaaring makatulong kapag sinusubukan ang mga workflow na may maraming interaksyon o nag-diagnose ng pag-uugali ng browser.
Kailan ko dapat iwasan ang mga browser nang buo?
Iwasan ang mga browser kapag ang simpleng HTTP requests ay nagbabalik ng kumpleto, wastong data. Ang mga browser ay mas mahal kaysa sa mga HTTP client at dapat gamitin kapag kinakailangan ang JavaScript rendering, interaksyon, o estado ng browser.
Anong mga metric ang nagpapatunay na sulit ang headful?
Tumingin para sa mas mataas na rate ng tagumpay, mas mababang retry depth, mas mahabang pagpapanatili ng session, at mas mababang CPSR sa kabila ng mas mataas na gastos sa compute. Kung ang mga metric na iyon ay hindi bumuti, maaaring hindi sulit ang pag-scale ng headful.
Ano ang pinakamahusay na setup para sa modernong scraping?
Ang pinakamahusay na setup ay karaniwang hybrid. Gumamit ng mga HTTP client para sa simpleng endpoints, headless na mga browser para sa scalable rendering, at headful na mga browser para sa pinakamahirap na mga workflow na sensitibo sa browser.
Pangwakas na Kaisipan
Ang headless vs headful na mga browser ay hindi dapat ituring na isang nakatakdang preference. Ito ay isang desisyon sa routing batay sa hirap ng target, pressure ng fingerprint, halaga ng data, at gastos.
Gamitin ang headless kung saan ito ay gumagana. Gamitin ang headful kung saan ito ay nagpapabuti sa wastong output nang sapat upang bigyang-katwiran ang karagdagang gastos. I-align ang browser mode sa uri ng proxy, patakaran ng session, at mga monitoring metrics.
Para sa suporta sa implementasyon, tuklasin ang mga proxy tutorials ng SquidProxies at mas malawak na proxy use cases upang ikonekta ang browser automation sa production-ready na proxy strategy.
Mga Kaugnay na Artikulo
Browser Fingerprinting para sa Web Scraping: Ano ang Maaaring Ayusin at Hindi Maaaring Ayusin ng Proxies
Isang praktikal na gabay sa browser fingerprinting sa web scraping at ang mga tiyak na problema na kayang lutasin at hindi kayang lutasin ng proxies. Kasama ang mga framework ng desisyon, mga failure modes, mga metrics na dapat subaybayan, at mga totoong senaryo para sa mga team na nag-run ng scraping, automation, at data collection sa malaking sukat.
WebRTC Leaks: Bakit Sila Nakakasira sa Anti-Detect Setups
Isang praktikal na gabay sa WebRTC leaks: paano nila naipapakita ang tunay na IP sa likod ng mga proxy, bakit sila nagti-trigger ng anti-bot flags, at paano ito maiiwasan sa iba't ibang browser at automation stacks—na may malinaw na mga desisyon, mga tip sa configuration, at mga metrics na dapat bantayan.
Browser Fingerprinting: Paliwanag para sa mga Scraper
Alamin kung paano naaapektuhan ng browser fingerprinting ang modernong web scraping at kung bakit hindi sapat ang proxies lamang para sa matatag na automation. Ang gabay na ito ay naglalarawan ng mga signal ng browser tulad ng user agent, WebRTC, canvas, timezone, at session behavior, kasama ang mga praktikal na estratehiya para mabawasan ang CAPTCHA, soft blocks, geo mismatches, at hindi matatag na browser sessions sa malaking sukat.